RMM Labs
7 мин четене 7 октомври 2026 г. От Fred

RAG в Xcellerate OPS: AI, който търси по смисъл

Xcellerate OPS вече индексира като вектори базата знания, плейбуците, документацията и решените тикети. Какво са RAG и ембедингите, какво изградихме и какво ще усети екипът.
RAG в Xcellerate OPS: AI, който търси по смисъл

Накратко: Xcellerate OPS вече използва генериране, подкрепено с извличане (RAG), върху векторен индекс на вашето собствено знание. Базата знания, плейбуците, документацията за клиентите, продуктовият каталог, проверените решения и категориите тикети се превръщат в ембединги с модела за ембединги на Mistral и се съхраняват в собствената база данни на вашето работно пространство. Когато AI колега търси, OPS съчетава класическото търсене по ключови думи с търсене по смисъл — така намира статията, която отговаря на въпроса, дори когато тикетът използва други думи. Чувствителните данни се премахват от текста, преди той да бъде превърнат в ембединг, документацията за конкретен клиент се показва само за този клиент, а търсенето по ключови думи продължава да работи, ако нещо във векторния път се провали.

Какво е RAG?

Големият езиков модел знае много за света, но нищо за вашите клиенти, вашите принтери или заобиколното решение, което старшият ви техник откри миналата пролет. Задайте му въпрос за вашата среда и той пак ще отговори — понякога убедително и погрешно.

Генерирането, подкрепено с извличане (RAG, retrieval-augmented generation), решава това, като разделя работата на две:

  1. Извличане. Преди моделът да отговори, системата намира пасажите от вашето собствено съдържание, които са най-относими към въпроса.
  2. Генериране. Моделът пише отговора си, като използва тези пасажи като изходен материал.

Представете си го като изпит с отворена книга. Моделът пак разсъждава и пише, но работи по вашата книга, а не по памет. Отговорът става по-добър в момента, в който бъде открита правилната страница — и вие виждате коя е тя.

Какво са ембедингите и векторната база данни?

Трудната част на RAG е първата стъпка: да се намери правилният пасаж. Класическото търсене сравнява думи. Тикет с текст „никой на втория етаж не може да печата“ няма да намери статия от базата знания със заглавие „Print spooler блокира след обновяване на драйвер“, макар че точно това е решението.

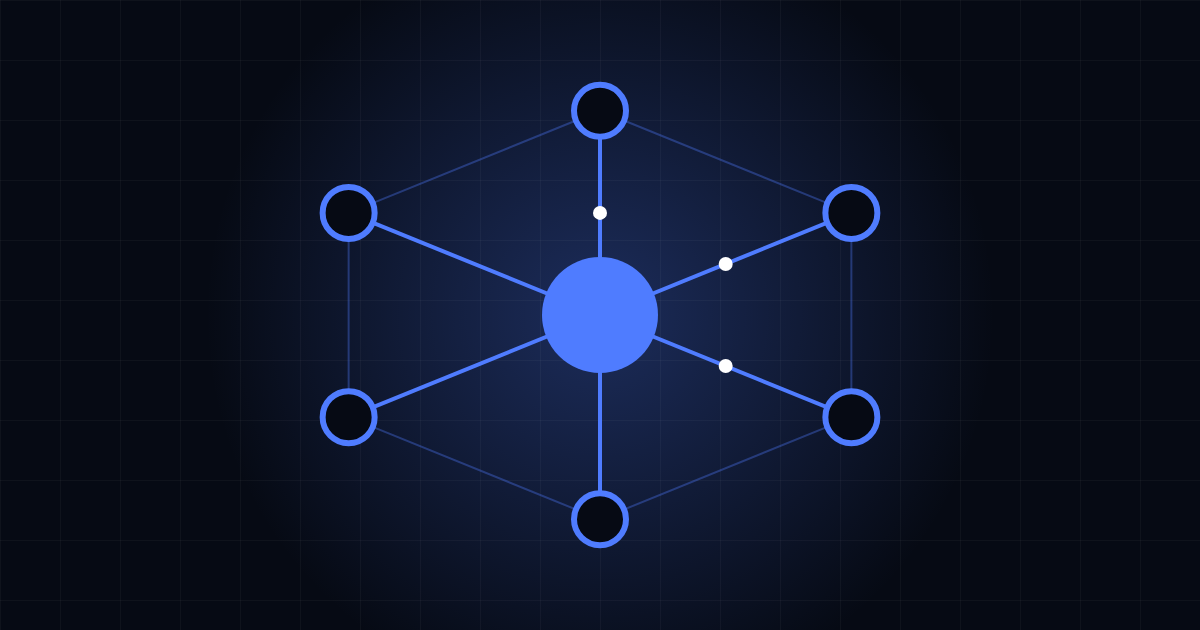
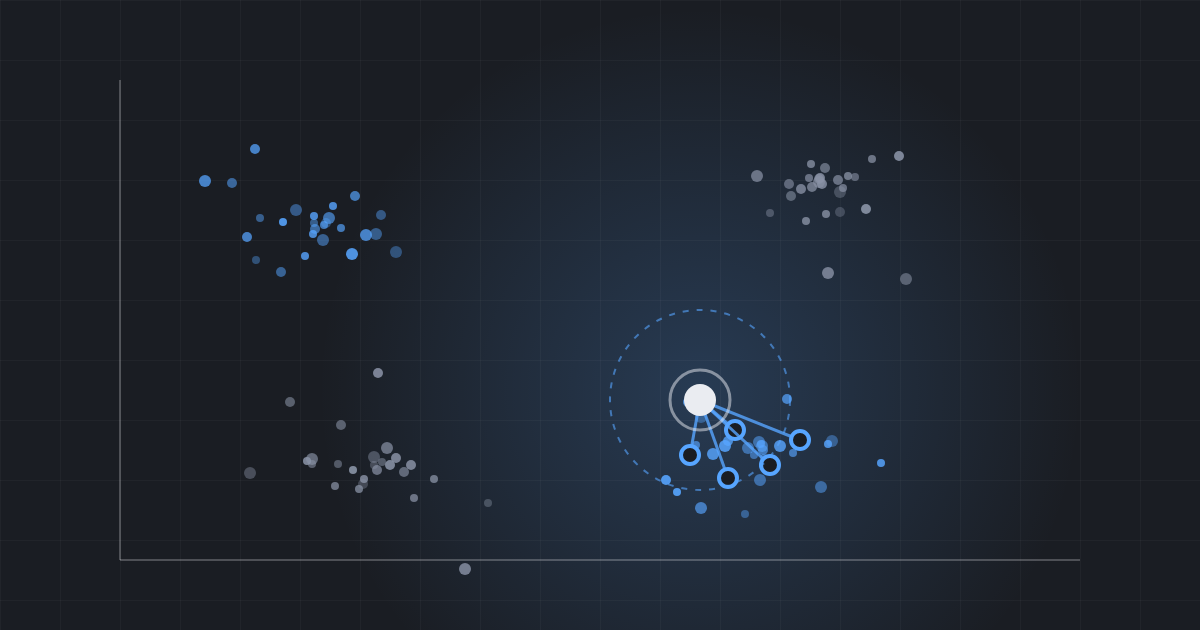
Ембедингите решават този проблем. Моделът за ембединги чете откъс текст и го превръща в дълъг списък от числа — вектор, който улавя какво означава текстът, а не какви думи използва. Текстове за едно и също нещо попадат близо един до друг в това пространство, дори когато нямат нито една обща дума. „Не мога да печатам“, „принтерът е офлайн за всички“ и „спулерът блокира“ се озовават близо един до друг; „просрочена фактура“ попада далеч от тях.

Векторната база данни (или векторен индекс) съхранява тези вектори и отговаря много бързо на един въпрос: кои от съхранените вектори са най-близо до този? Близостта обикновено се измерва с косинусово сходство — ъгъла между два вектора. Заявката за търсене се превръща във вектор със същия модел, а най-близките пасажи са кандидатите, които езиковият модел получава за четене.

Защо това е важно за сервизното бюро

  • Хората описват проблемите със свои думи. Клиентите пишат симптоми, техниците пишат решения. Търсенето по смисъл свързва двете.
  • Знанието ви е разпръснато. Статии от базата знания, плейбуци, документация по клиенти, бележки за продукти и решенията, които екипът ви вече е намерил. RAG позволява на AI колегата да прочете всичко това точно в момента, в който му трябва.
  • Обоснованите отговори могат да се проверят. Когато отговорът е изграден от конкретна статия или плейбук, техникът може да отвори източника и да го провери. В това е разликата между асистент, на когото можете да се доверите, и такъв, когото трябва да проверявате от нулата.
  • По-малко гадаене, по-малко повтарящи се въпроси. Когато AI намери по-ранното решение, старшият техник не бива питан за трети път този месец.

Какво вградихме в Xcellerate OPS

Един семантичен индекс за всяко работно пространство

OPS поддържа семантичен индекс на шест вида съдържание:

  • статии от базата знания (папките се пропускат);
  • плейбуци, включително бележката „прилага се, когато“ и процедурата;
  • документация, която водите за всеки клиент;
  • продукти от каталога ви, с тяхното описание и AI инструкции;
  • решения, дестилирани от решени тикети (решение, което ръководител на екип е маркирал като грешно, се изключва);
  • категории тикети и AI подсказките, които сте написали за тях.

Всеки елемент се разделя на припокриващи се части от около 800 токена, така че дългата статия става няколко пасажа за търсене и печели най-добрият пасаж. Индексът се намира в собствената база данни на вашето работно пространство, до данните, които описва. Документацията, която принадлежи на един клиент, се връща само когато AI работи за този клиент.

Ембединги от Mistral

Векторите се създават от модела за ембединги на Mistral, mistral-embed, който генерира вектори с 1024 измерения. Тук са важни две предпазни мерки:

  • Първо се премахват чувствителните данни. Всеки текст минава през същата стъпка за премахване на чувствителни данни като всяко друго AI извикване в OPS, преди да напусне платформата. Личните данни, като имейл адресите, се заменят със заместители.
  • Един модел, едно пространство. Вектори от два различни модела не могат да се сравняват. Ако някога е нужен резервен доставчик, OPS превключва само към доставчик, който предлага същия модел, така че индексът никога не се смесва.

Хибридно търсене: ключови думи и смисъл заедно

OPS никога не разчита само на вектори. Всяко търсене минава по два пътя:

  1. търсене по ключови думи в заглавията и извлечените ключови думи, което винаги се изпълнява;
  2. векторно търсене на пасажите, които са най-близо по смисъл до въпроса.

Двата списъка с резултати се обединяват с reciprocal rank fusion (реципрочно сливане на класирания): елемент, който се класира добре в един от списъците, се изкачва нагоре, а елемент, който се класира добре и в двата, се изкачва най-много. Твърде слабите векторни съвпадения (косинусово сходство под 0,2) се отхвърлят като шум, а всеки документ се появява веднъж, представен от най-добрия си пасаж. Продуктов код или номер на грешка, който хваща само търсенето по ключови думи, никога не се губи, а перифразиран симптом, който хваща само търсенето по смисъл, също се намира.

Нативно векторно търсене с предпазна мрежа

Там, където базата данни поддържа нативно векторно търсене, OPS го използва (косинусово разстояние в SQL). Там, където не го поддържа, вграден механизъм сам изчислява сходството. Ако нативният път се провали по каквато и да е причина, търсенето преминава към вградения механизъм за тази заявка. Извличането никога не спира да работи заради векторния слой.
Винаги актуален, никога платен два пъти

  • Когато някой запише статия от базата знания, плейбук, документ, продукт, решение или категория, OPS го индексира наново малко след записа. Изтриването премахва векторите му.
  • Отново се превръщат в ембединги само пасажите, чието съдържание се е променило; всяка част носи хеш на съдържанието си. Идентичен текст използва вече съществуващ вектор, вместо да се плаща за нов.
  • Векторът на въпроса при търсене също се кешира: един и същ въпрос се превръща в ембединг само веднъж.
  • По време на импорт на данни нищо не се поставя в опашка; нощно съгласуване наваксва след това.

Къде го забелязва екипът ви

  • AI колегите търсят по-добре. Търсенията им в базата знания, плейбуците, документацията и продуктите поставят семантичните съвпадения на първо място, а съвпаденията по ключови думи следват след тях.
  • Свързано съдържание към тикета. За категорията на тикета AI колегата получава съдържанието, което сте свързали, решенията, които преди са решили подобни тикети, и документите, най-близки по смисъл до заглавието на тикета.
  • По-чиста памет за решения. Ново решение, което е почти идентично (косинусово сходство 0,92 или повече) с вече съхранено решение за същата категория, се третира като същото решение, така че списъкът ви не се пълни с дубликати.

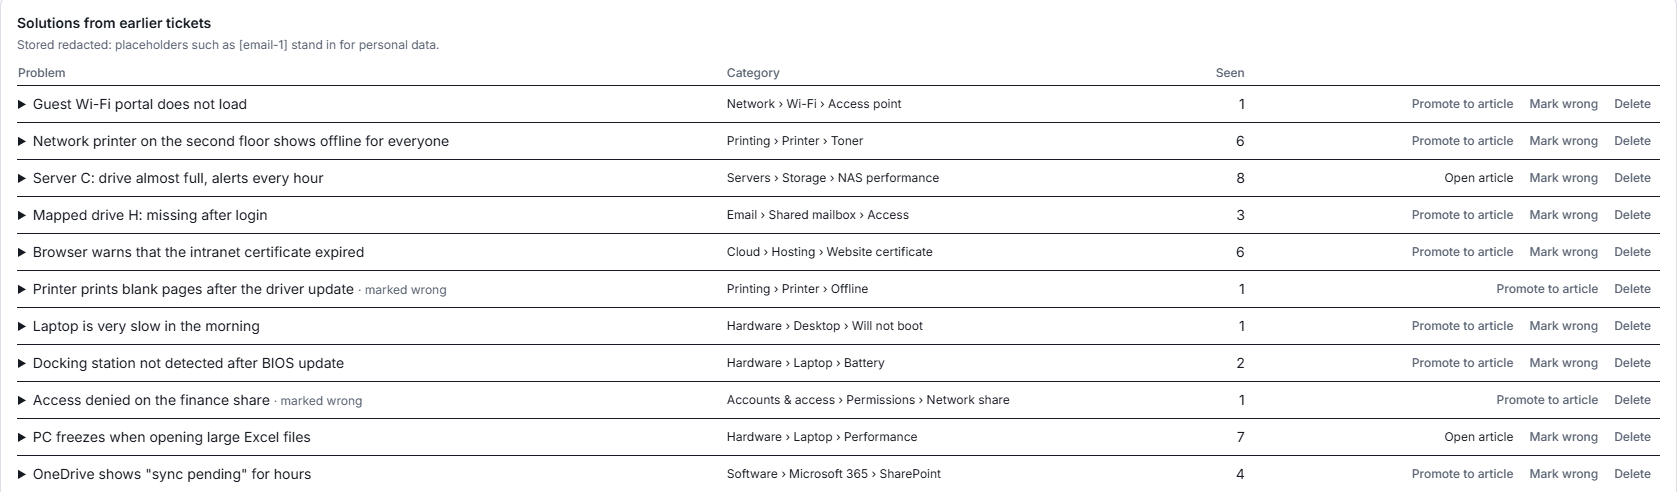
Списъкът с решения на страницата AI памет в Xcellerate OPS, с „Превърни в статия“, „Маркирай като грешно“ и „Изтрий“ на всеки ред Реална екранна снимка от нашата демо среда, с измислени данни.

Поверителност и контрол

  • Чувствителните данни се премахват от текста, преди той да бъде превърнат в ембединг, а съхранените решения запазват заместителите.
  • Индексът се намира в собствената база данни на вашето работно пространство; документацията за клиент е ограничена до този клиент.
  • Ръководител на екип може да маркира решение като грешно (то напуска индекса) или да го изтрие; изтриването на всеки индексиран елемент премахва векторите му.
  • AI аварийният прекъсвач спира създаването на ембединги заедно с всяко друго AI извикване.
  • Центърът за прозрачност на AI (AI Transparency Center) вписва AI паметта във вашия регистър по AI Act („пази се до заличаване или изтриване; съхранява се без чувствителни данни“), а Настройки → AI памет показва какво съдържа паметта. Повече за регистъра ще намерите на страницата ни за управление на AI.

Редът за AI памет в регистъра по AI Act на Xcellerate OPS: минимален риск, само съвещателна роля, пази се до заличаване или изтриване, съхранява се без чувствителни данни Реална екранна снимка от нашата демо среда; една колона е замъглена.

Колко струва

Създаването на ембединги използва AI кредити в категорията AI памет, а всяко извикване се записва като всяко друго AI действие. Тъй като непроменените пасажи и повтарящите се въпроси никога не се превръщат в ембединги два пъти, разходът следва колко се променя знанието ви, а не колко често търси екипът ви. Страницата Oversight в Центъра за прозрачност на AI показва какво е спестило повторното използване.

Как да започнете

Няма нищо за включване: индексирането започва само и се актуализира, докато съдържанието ви се променя. Колкото повече записвате в статии, плейбуци и документация за клиенти и колкото повече тикети решавате, толкова повече материал имат AI колегите ви, с който да работят.

Ако сте нови в Xcellerate OPS, страницата за AI колегите обяснява какво правят колегите, а статията ни Всеки затворен тикет прави следващия по-евтин разказва за AI паметта, от която е част този индекс.

Започнете безплатно

Често задавани въпроси

Какво е RAG с прости думи?
Генерирането, подкрепено с извличане, означава, че AI първо намира най-относимите пасажи във вашето собствено съдържание и след това пише отговора си въз основа на тях — като изпит с отворена книга.
Трябва ли да включа нещо?
Не. Индексирането започва само и се актуализира, когато статии, плейбуци, документация, продукти, решения и категории бъдат записани или изтрити.
Какъв модел за ембединги използва Xcellerate OPS?
Модела mistral-embed на Mistral, който генерира вектори с 1024 измерения. Чувствителните данни се премахват от текста, преди той да бъде изпратен.
Продължава ли да работи търсенето по ключови думи?
Да. Всяко търсене изпълнява заедно търсене по ключови думи и векторно търсене и обединява резултатите. Ако векторният път се провали, търсенето по ключови думи пак дава отговор.
Може ли документацията за един клиент да изтече към друг клиент?
Не. Документацията, която принадлежи на един клиент, се връща само когато AI работи за този клиент.
Източници: Програмен код и документация на продукта Xcellerate OPS (RMM Labs, октомври 2026 г.)

Готови ли сте да решите съответствието при отчитане на работното време?

Xcellerate OPS покрива белгийските изисквания за отчитане на работното време от 2027 г. по подразбиране — без допълнителен модул.
Свързани статии