6 okt 2026
Xcellerate OPS indexeert je kennisbank, playbooks, documentatie en opgeloste tickets als vectoren. Wat RAG en embeddings zijn, wat we bouwden en wat je team merkt.
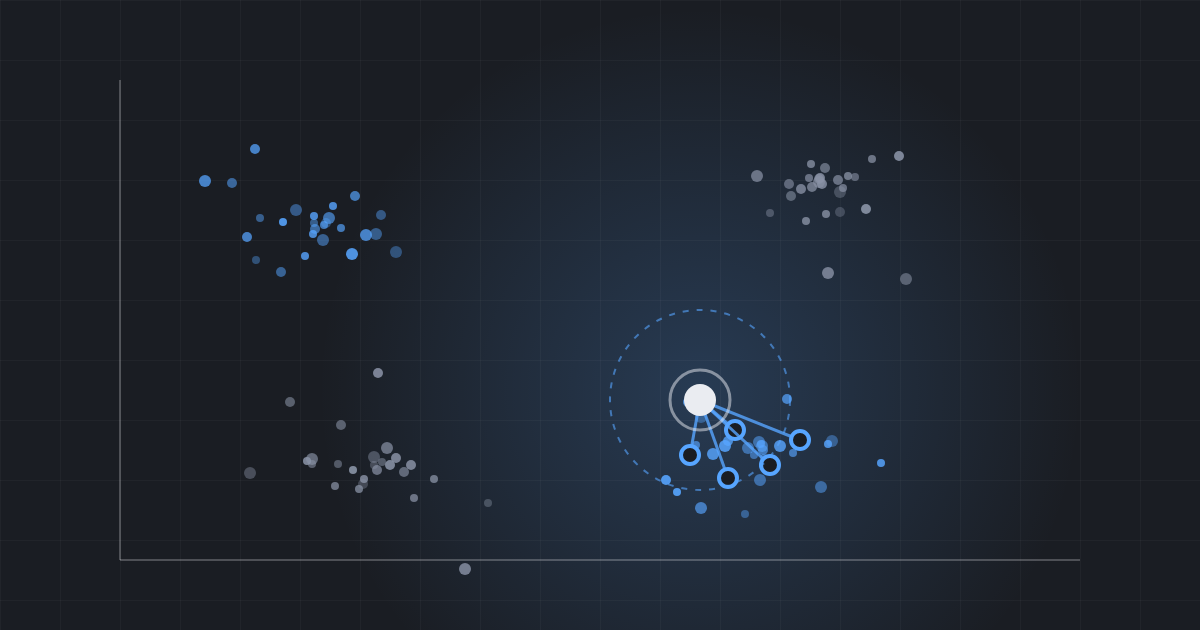
In het kort: Xcellerate OPS draait voortaan retrieval-augmented generation (RAG) bovenop een vectorindex van je eigen kennis. Je kennisbank, playbooks, klantdocumentatie, productcatalogus, nagekeken oplossingen en ticketcategorieën worden met het embeddingmodel van Mistral omgezet in embeddings en opgeslagen in de eigen database van je werkruimte. Wanneer een AI-collega zoekt, combineert OPS het klassieke zoeken op trefwoorden met zoeken op betekenis. Zo vindt hij het artikel dat de vraag beantwoordt, ook als het ticket andere woorden gebruikt. Tekst wordt afgeschermd vóór hij wordt omgezet, klantspecifieke documentatie verschijnt alleen voor die klant, en zoeken op trefwoorden blijft werken als er in het vectorgedeelte iets misloopt.
Een groot taalmodel weet veel over de wereld, maar niets over jouw klanten, jouw printers of de workaround die je meest ervaren technicus vorige lente heeft gevonden. Stel het een vraag over je omgeving en het antwoordt toch, soms overtuigend en verkeerd.
Retrieval-augmented generation (RAG), vrij vertaald: antwoorden genereren op basis van opgezochte informatie, lost dat op door het werk in twee te splitsen:
Zie het als een examen met open boek. Het model doet nog altijd het denkwerk en het schrijfwerk, maar het werkt vanuit jouw boek in plaats van uit het hoofd. Het antwoord wordt beter zodra de juiste pagina gevonden is, en je kunt zien welke pagina dat was.
Het moeilijke deel van RAG is de eerste stap: de juiste passage vinden. Klassiek zoeken vergelijkt woorden. Een ticket met "niemand op de tweede verdieping kan printen" vindt geen KB-artikel met de titel "Afdrukspooler hangt na een driverupdate", hoewel dat precies de oplossing is.
Embeddings lossen dat op. Een embeddingmodel leest een stuk tekst en zet het om in een lange reeks getallen, een vector, die vastlegt wat de tekst betekent in plaats van welke woorden hij gebruikt. Teksten over hetzelfde onderwerp komen in die ruimte dicht bij elkaar terecht, ook als ze geen enkel woord gemeen hebben. "Kan niet printen", "printer offline voor iedereen" en "spooler hangt" liggen dicht bij elkaar; "factuur vervallen" ligt ver weg.
Een vectordatabase (of vectorindex) bewaart die vectoren en beantwoordt één vraag heel snel: welke opgeslagen vectoren liggen het dichtst bij deze? Die nabijheid wordt meestal gemeten met cosinusgelijkenis, de hoek tussen twee vectoren. De zoekvraag wordt met hetzelfde model omgezet in een vector, en de dichtstbijzijnde passages zijn de kandidaten die het taalmodel te lezen krijgt.
OPS houdt een semantische index bij van zes soorten inhoud:
Elk item wordt opgedeeld in overlappende stukken van ongeveer 800 tokens. Zo wordt een lang artikel meerdere doorzoekbare passages, en wint de beste passage. De index staat in de eigen database van je werkruimte, naast de gegevens die hij beschrijft. Documentatie die bij één klant hoort, komt alleen naar boven wanneer de AI voor die klant werkt.
De vectoren worden gemaakt door het embeddingmodel van Mistral, mistral-embed, dat vectoren met 1.024 dimensies produceert. Twee waarborgen zijn hier belangrijk:
OPS vertrouwt nooit alleen op vectoren. Elke zoekopdracht volgt twee paden:
De twee resultatenlijsten worden samengevoegd met reciprocal rank fusion: een item dat hoog scoort in een van beide lijsten stijgt, een item dat hoog scoort in allebei stijgt het meest. Vectortreffers die te zwak zijn (cosinusgelijkenis onder 0,2) worden als ruis weggelaten, en elk document verschijnt één keer, vertegenwoordigd door zijn beste passage. Een productcode of foutnummer dat alleen zoeken op trefwoorden opvangt, gaat nooit verloren, en een anders verwoord symptoom dat alleen zoeken op betekenis opvangt, wordt ook gevonden.
Waar de database native vectorzoeken ondersteunt, gebruikt OPS dat (cosinusafstand in SQL). Waar dat niet kan, berekent een ingebouwde engine de gelijkenis zelf. Loopt het native pad om welke reden ook mis, dan valt de zoekopdracht voor die vraag terug op de ingebouwde engine. Het opzoeken valt nooit uit door de vectorlaag.
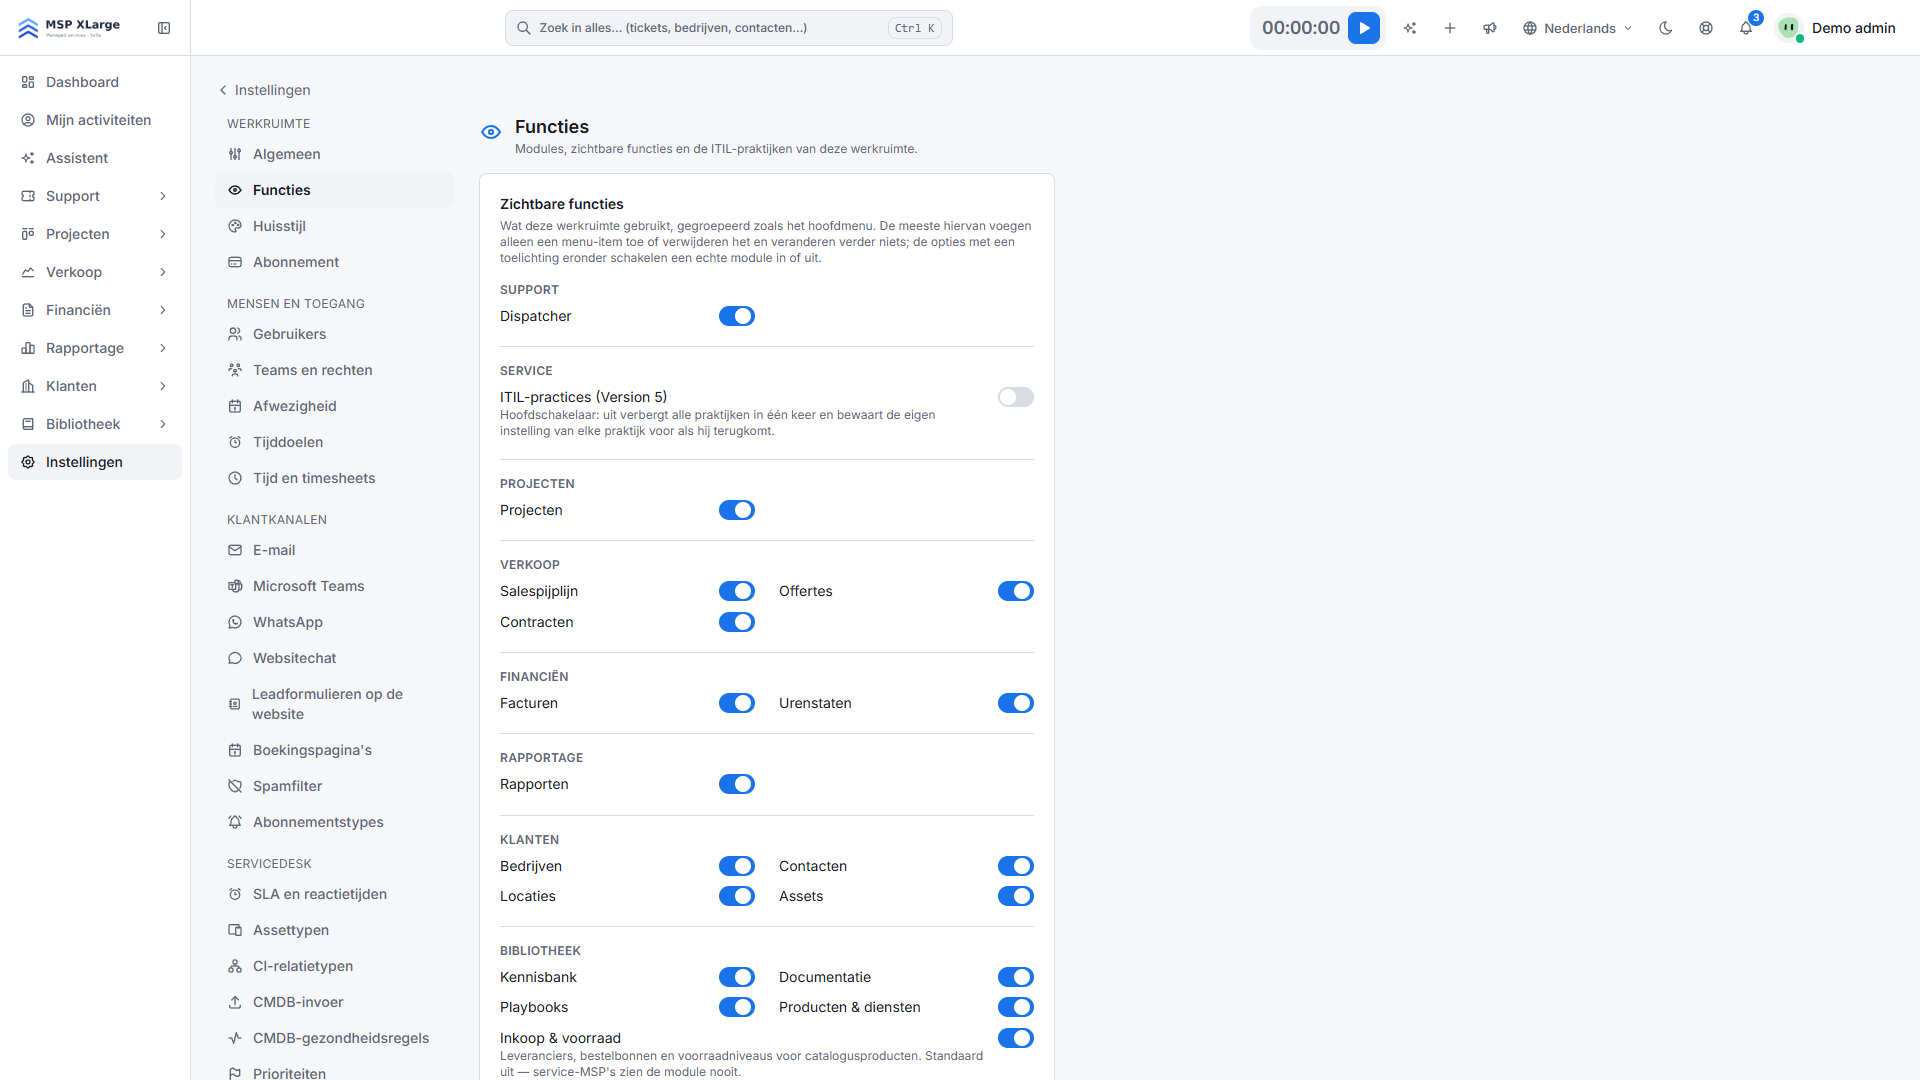
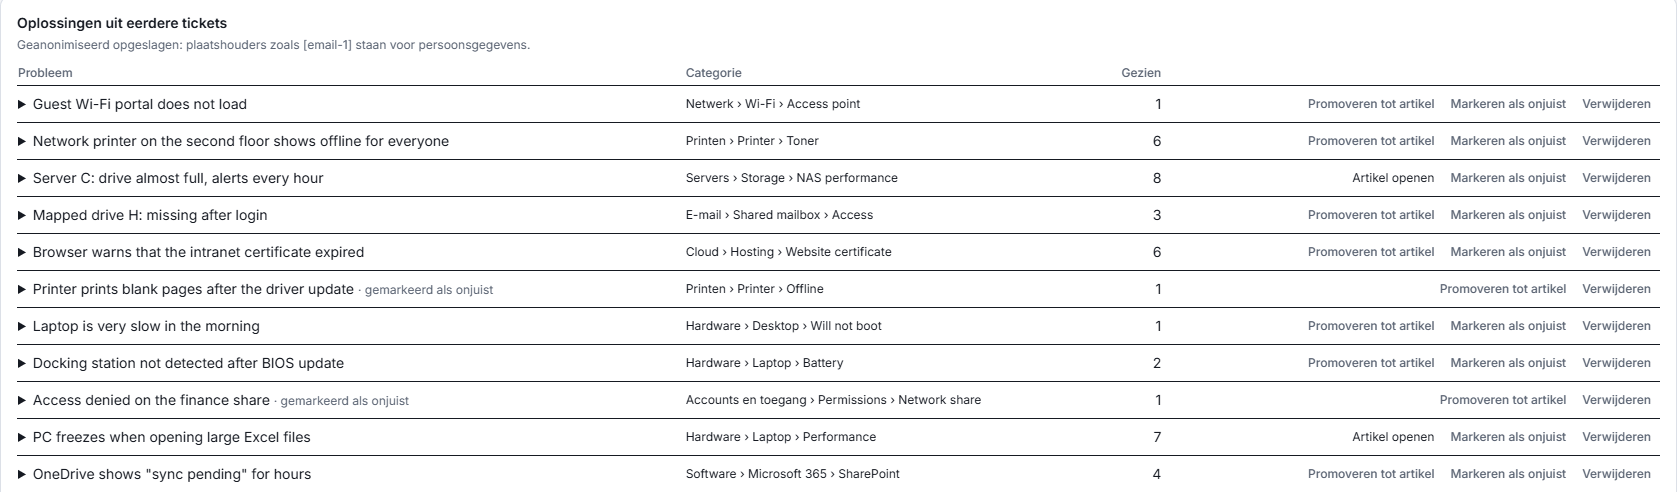 Echte screenshot uit onze demo-omgeving, met fictieve gegevens.
 Echte screenshot uit onze demo-omgeving; één kolom is vervaagd.
Embeddings maken verbruikt AI-credits in de categorie AI-geheugen, en elke oproep wordt gelogd zoals elke andere AI-actie. Omdat ongewijzigde passages en herhaalde vragen nooit twee keer worden omgezet, volgt de kost hoeveel je kennis verandert, niet hoe vaak je team zoekt. De Oversight-pagina in het AI Transparency Center toont wat het hergebruik heeft bespaard.
Er valt niets aan te zetten: het indexeren start vanzelf en blijft bij wanneer je inhoud verandert. Hoe meer je vastlegt in artikelen, playbooks en klantdocumentatie, en hoe meer tickets je oplost, hoe meer materiaal je AI-collega's hebben om mee te werken.
Ben je nieuw bij Xcellerate OPS? Op de pagina over AI-collega's lees je wat de collega's doen, en ons artikel over hoe elk ticket dat je afsluit het volgende goedkoper maakt gaat over het AI-geheugen waar deze index deel van uitmaakt.
Xcellerate OPS dekt de Belgische tijdregistratieplicht van 2027 standaard — geen extra module nodig.