6 paź 2026
Xcellerate OPS indeksuje bazę wiedzy, playbooki, dokumentację i rozwiązane zgłoszenia jako wektory. Czym są RAG i embeddingi, co zbudowaliśmy i co zauważy zespół.
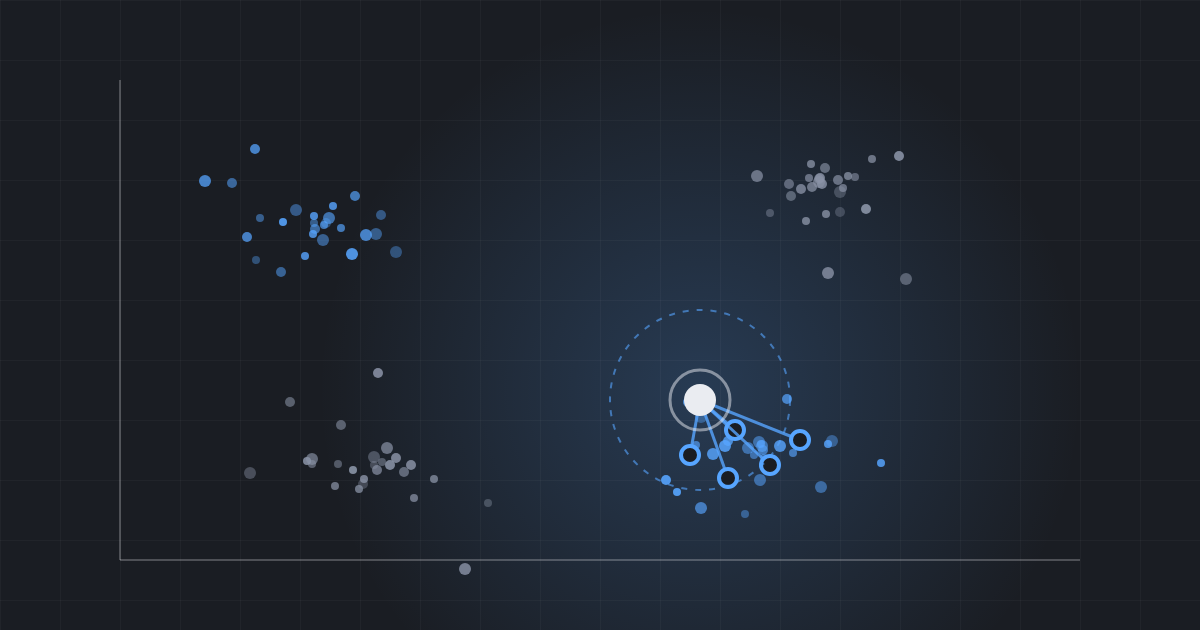
W skrócie: Xcellerate OPS stosuje teraz RAG (retrieval-augmented generation, czyli generowanie wspomagane wyszukiwaniem) na indeksie wektorowym Państwa własnej wiedzy. Baza wiedzy, playbooki, dokumentacja klientów, katalog produktów, zweryfikowane rozwiązania i kategorie zgłoszeń są zamieniane na embeddingi przez model embeddingów Mistral i przechowywane we własnej bazie danych Państwa przestrzeni roboczej. Gdy współpracownik AI czegoś szuka, OPS łączy klasyczne wyszukiwanie po słowach kluczowych z wyszukiwaniem po znaczeniu. Dzięki temu znajduje artykuł, który odpowiada na pytanie, nawet jeśli zgłoszenie używa innych słów. Tekst jest maskowany, zanim powstanie z niego embedding, dokumentacja konkretnego klienta pojawia się tylko przy pracy dla tego klienta, a wyszukiwanie po słowach kluczowych działa dalej, jeśli cokolwiek na ścieżce wektorowej zawiedzie.
Duży model językowy wie wiele o świecie, ale nic o Państwa klientach, Państwa drukarkach ani o obejściu, które starszy technik znalazł zeszłej wiosny. Zapytany o Państwa środowisko i tak odpowie – czasem przekonująco, a jednak błędnie.
Generowanie wspomagane wyszukiwaniem (RAG) rozwiązuje ten problem, dzieląc pracę na dwa etapy:
To jak egzamin z otwartą książką. Model nadal sam rozumuje i pisze, ale korzysta z Państwa książki zamiast z pamięci. Odpowiedź staje się lepsza, gdy tylko zostanie znaleziona właściwa strona – i widać, która to była strona.
Najtrudniejszy w RAG jest pierwszy krok: znalezienie właściwego fragmentu. Klasyczne wyszukiwanie dopasowuje słowa. Zgłoszenie „nikt na drugim piętrze nie może drukować” nie znajdzie artykułu bazy wiedzy zatytułowanego „Bufor wydruku zawiesza się po aktualizacji sterownika”, choć to dokładnie właściwe rozwiązanie.
Embeddingi rozwiązują ten problem. Model embeddingów czyta fragment tekstu i zamienia go w długą listę liczb – wektor – który oddaje znaczenie tekstu, a nie użyte w nim słowa. Teksty o tym samym trafiają w tej przestrzeni blisko siebie, nawet jeśli nie mają ani jednego wspólnego słowa. „Nie mogę drukować”, „drukarka offline u wszystkich” i „bufor wydruku zawieszony” lądują obok siebie; „zaległa faktura” ląduje daleko.
Baza wektorowa (lub indeks wektorowy) przechowuje te wektory i bardzo szybko odpowiada na jedno pytanie: które zapisane wektory są najbliżej tego jednego? Bliskość mierzy się zwykle podobieństwem kosinusowym, czyli kątem między dwoma wektorami. Zapytanie jest zamieniane na wektor tym samym modelem, a najbliższe fragmenty stają się kandydatami, które przeczyta model językowy.
OPS utrzymuje indeks semantyczny sześciu rodzajów treści:
Każdy element jest dzielony na nakładające się fragmenty o długości około 800 tokenów, więc długi artykuł staje się kilkoma przeszukiwalnymi fragmentami i wygrywa ten najlepszy. Indeks znajduje się we własnej bazie danych Państwa przestrzeni roboczej, obok danych, które opisuje. Dokumentacja należąca do jednego klienta jest zwracana tylko wtedy, gdy AI pracuje dla tego klienta.
Wektory tworzy model embeddingów Mistral, mistral-embed, który generuje wektory o 1024 wymiarach. Ważne są tu dwa zabezpieczenia:
OPS nigdy nie polega wyłącznie na wektorach. Każde wyszukiwanie biegnie dwiema ścieżkami:
Obie listy wyników są łączone metodą reciprocal rank fusion: element wysoko na którejkolwiek liście awansuje, a element wysoko na obu awansuje najbardziej. Zbyt słabe dopasowania wektorowe (podobieństwo kosinusowe poniżej 0,2) są odrzucane jako szum, a każdy dokument pojawia się raz, reprezentowany przez swój najlepszy fragment. Kod produktu czy numer błędu, który wychwytuje tylko wyszukiwanie po słowach kluczowych, nigdy nie przepada – a objaw opisany innymi słowami, który wychwytuje tylko znaczenie, również zostaje znaleziony.
Tam, gdzie baza danych obsługuje natywne wyszukiwanie wektorowe, OPS z niego korzysta (odległość kosinusowa w SQL). Tam, gdzie nie, wbudowany silnik sam oblicza podobieństwo. Jeśli ścieżka natywna z jakiegokolwiek powodu zawiedzie, wyszukiwanie dla tego zapytania przełącza się na wbudowany silnik. Wyszukiwanie nigdy nie przestaje działać z powodu warstwy wektorowej.
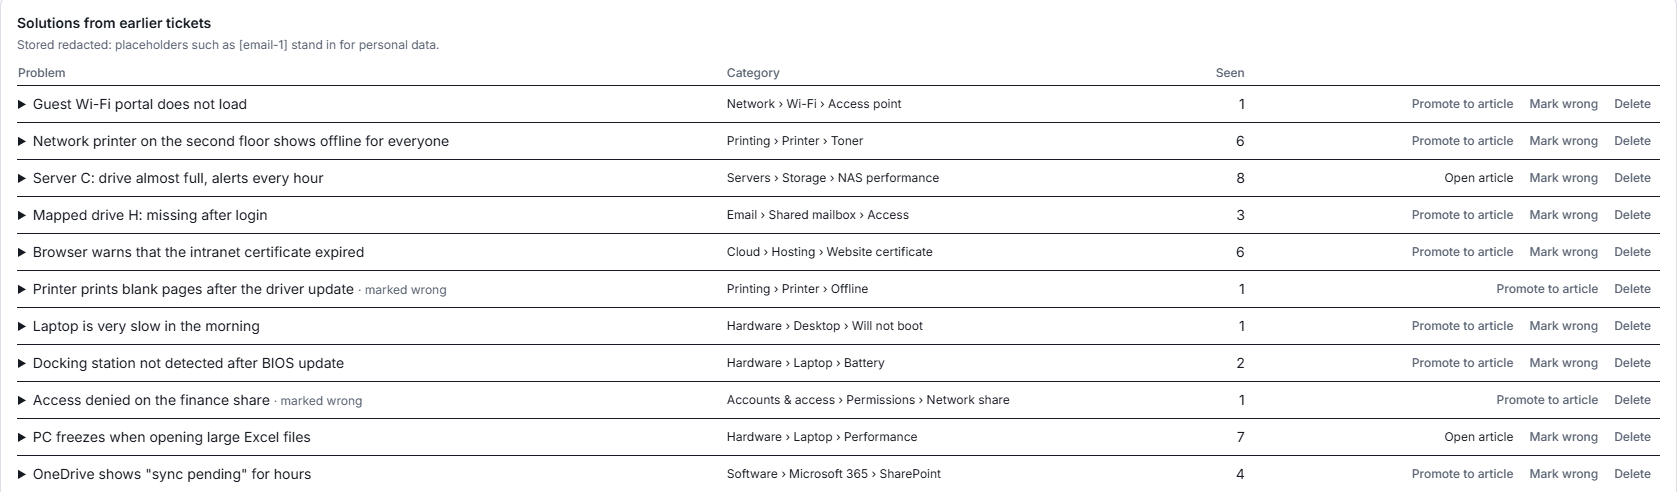 Prawdziwy zrzut ekranu z naszego środowiska demonstracyjnego, z fikcyjnymi danymi.
 Prawdziwy zrzut ekranu z naszego środowiska demonstracyjnego; jedna kolumna jest rozmyta.
Tworzenie embeddingów zużywa kredyty AI w kategorii pamięci AI, a każde wywołanie jest rejestrowane jak każde inne działanie AI. Ponieważ niezmienione fragmenty i powtarzane pytania nigdy nie są przetwarzane dwa razy, koszt zależy od tego, jak bardzo zmienia się Państwa wiedza, a nie od tego, jak często zespół wyszukuje. Strona Oversight w Centrum przejrzystości AI pokazuje, ile zaoszczędziło ponowne wykorzystanie.
Nie trzeba niczego włączać: indeksowanie startuje samo i nadąża za zmianami w treściach. Im więcej zapiszą Państwo w artykułach, playbookach i dokumentacji klientów i im więcej zgłoszeń rozwiąże zespół, tym więcej materiału mają do pracy współpracownicy AI.
Jeśli dopiero poznają Państwo Xcellerate OPS, strona o współpracownikach AI wyjaśnia, co robią współpracownicy, a nasz artykuł o tym, jak każde zamknięte zgłoszenie obniża koszt następnego, opisuje pamięć AI, której częścią jest ten indeks.
Xcellerate OPS domyślnie obejmuje belgijskie wymogi rejestracji czasu pracy z 2027 roku — bez dodatkowego modułu.