RMM Labs
8 min de lectura 7 de octubre de 2026 Por Fred

RAG en Xcellerate OPS: IA que busca por significado

Xcellerate OPS indexa ya como vectores su base de conocimiento, playbooks, documentación y tickets resueltos. Qué son RAG y los embeddings, y qué notará su equipo.
RAG en Xcellerate OPS: IA que busca por significado

En resumen: Xcellerate OPS aplica ahora la generación aumentada por recuperación (RAG) sobre un índice vectorial de su propio conocimiento. Su base de conocimiento, sus playbooks, la documentación de sus clientes, su catálogo de productos, las soluciones revisadas y las categorías de tickets se convierten en embeddings con el modelo de embeddings de Mistral y se almacenan en la propia base de datos de su espacio de trabajo. Cuando un colega de IA busca, OPS combina la búsqueda clásica por palabras clave con la búsqueda por significado, de modo que encuentra el artículo que responde a la pregunta aunque el ticket use otras palabras. El texto se enmascara antes de convertirse en embedding, la documentación específica de un cliente solo aparece para ese cliente y la búsqueda por palabras clave sigue funcionando si algo falla en la parte vectorial.

¿Qué es RAG?

Un gran modelo de lenguaje sabe mucho sobre el mundo, pero nada sobre sus clientes, sus impresoras o la solución alternativa que su técnico sénior descubrió la primavera pasada. Hágale una pregunta sobre su entorno y responderá de todos modos, a veces de forma convincente y equivocada.

La generación aumentada por recuperación (RAG, por sus siglas en inglés) lo resuelve dividiendo el trabajo en dos:

  1. Recuperar. Antes de que el modelo responda, el sistema busca en su propio contenido los pasajes más relevantes para la pregunta.
  2. Generar. El modelo redacta su respuesta usando esos pasajes como material de partida.

Piense en un examen a libro abierto. El modelo sigue razonando y redactando, pero trabaja con su libro en lugar de con su memoria. La respuesta mejora en cuanto se encuentra la página correcta, y usted puede ver cuál era.

¿Qué son los embeddings y una base de datos vectorial?

La parte difícil de RAG es el primer paso: encontrar el pasaje adecuado. La búsqueda clásica compara palabras. Un ticket que dice «nadie en la segunda planta puede imprimir» no encontrará un artículo de la base de conocimiento titulado «La cola de impresión se bloquea tras actualizar el controlador», aunque esa sea exactamente la solución.

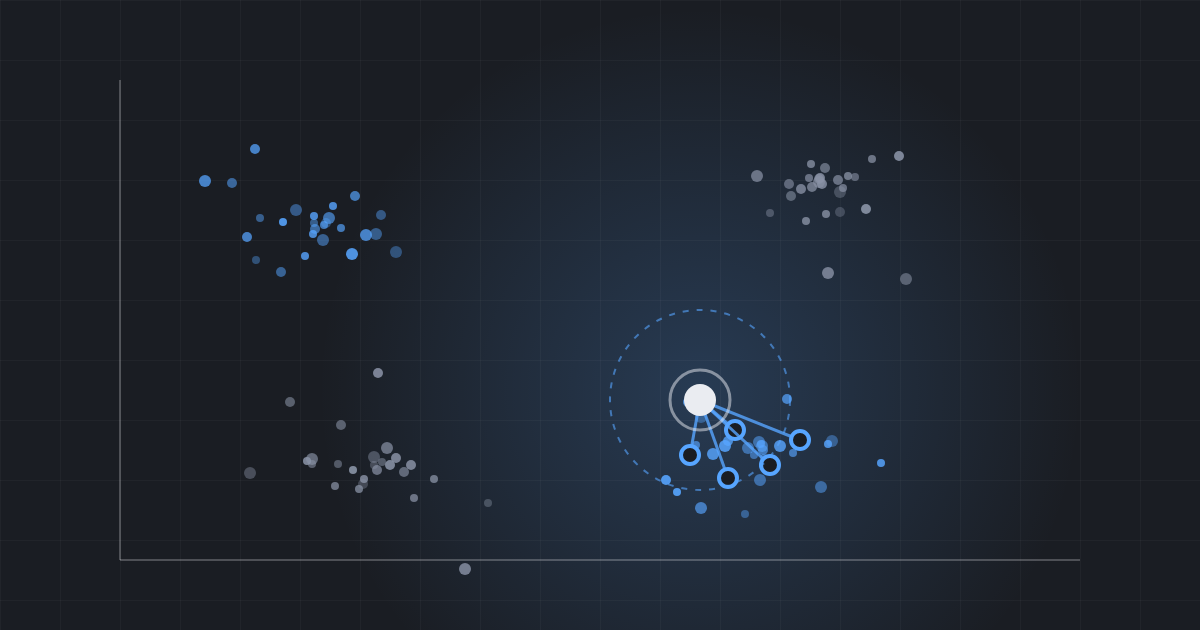
Los embeddings resuelven este problema. Un modelo de embeddings lee un fragmento de texto y lo convierte en una larga lista de números, un vector, que recoge lo que el texto significa y no qué palabras utiliza. Los textos que tratan de lo mismo quedan cerca unos de otros en ese espacio, aunque no compartan ninguna palabra. «No puedo imprimir», «impresora desconectada para todos» y «cola de impresión bloqueada» quedan cerca; «factura vencida» queda lejos.

Una base de datos vectorial (o índice vectorial) almacena esos vectores y responde muy rápido a una sola pregunta: ¿qué vectores almacenados están más cerca de este? La cercanía suele medirse con la similitud coseno, el ángulo entre dos vectores. La consulta de búsqueda se convierte en un vector con el mismo modelo, y los pasajes más cercanos son los candidatos que lee el modelo de lenguaje.

Por qué importa en un service desk

  • Cada persona describe los problemas con sus propias palabras. Los clientes escriben síntomas, los técnicos escriben soluciones. La búsqueda por significado une ambos lenguajes.
  • Su conocimiento está repartido. Artículos de la base de conocimiento, playbooks, documentación por cliente, notas de producto y las soluciones que su equipo ya encontró. RAG permite que un colega de IA lo lea todo justo cuando lo necesita.
  • Las respuestas fundamentadas se pueden comprobar. Cuando una respuesta se construye a partir de un artículo o un playbook concreto, el técnico puede abrir la fuente y verificarla. Esa es la diferencia entre un asistente en el que se puede confiar y uno que hay que revisar desde cero.
  • Menos conjeturas, menos preguntas repetidas. Cuando la IA encuentra la solución anterior, nadie tiene que preguntar al técnico sénior por tercera vez en el mes.

Qué hemos integrado en Xcellerate OPS

Un índice semántico por espacio de trabajo

OPS mantiene un índice semántico de seis tipos de contenido:

  • Artículos de la base de conocimiento (las carpetas se omiten);
  • Playbooks, incluida su nota «se aplica cuando» y el procedimiento;
  • Documentación que guarda por cliente;
  • Productos de su catálogo, con su descripción y sus instrucciones para la IA;
  • Soluciones extraídas de tickets resueltos (se excluye una solución que un responsable de equipo haya marcado como incorrecta);
  • Categorías de tickets y las indicaciones para la IA que usted redactó para ellas.

Cada elemento se divide en fragmentos solapados de unos 800 tokens, de modo que un artículo largo se convierte en varios pasajes buscables y gana el mejor pasaje. El índice reside en la propia base de datos de su espacio de trabajo, junto a los datos que describe. La documentación que pertenece a un cliente solo se devuelve cuando la IA trabaja para ese cliente.

Embeddings de Mistral

Los vectores los genera el modelo de embeddings de Mistral, mistral-embed, que produce vectores de 1.024 dimensiones. Aquí importan dos salvaguardas:

  • Primero se enmascara. Todo texto pasa por el mismo paso de enmascaramiento que cualquier otra llamada a la IA en OPS antes de salir de la plataforma. Los datos personales, como las direcciones de correo electrónico, se sustituyen por marcadores.
  • Un modelo, un espacio. Los vectores de dos modelos distintos no se pueden comparar. Si alguna vez hace falta un proveedor de respaldo, OPS solo recurre a un proveedor que sirva el mismo modelo, para que el índice nunca se mezcle.

Búsqueda híbrida: palabras clave y significado a la vez

OPS nunca depende solo de los vectores. Cada búsqueda sigue dos vías:

  1. Búsqueda por palabras clave en los títulos y en las palabras clave extraídas, que siempre se ejecuta;
  2. Búsqueda vectorial de los pasajes más cercanos en significado a la pregunta.

Las dos listas de resultados se combinan con reciprocal rank fusion (fusión por rango recíproco): un elemento bien situado en cualquiera de las dos listas sube, y uno bien situado en ambas sube todavía más. Las coincidencias vectoriales demasiado débiles (similitud coseno inferior a 0,2) se descartan como ruido, y cada documento aparece una sola vez, representado por su mejor pasaje. Así no se pierde nunca un código de producto o un número de error que solo detecta la búsqueda por palabras clave, y también se encuentra un síntoma descrito con otras palabras que solo detecta la búsqueda por significado.

Búsqueda vectorial nativa, con red de seguridad

Cuando la base de datos admite búsqueda vectorial nativa, OPS la utiliza (distancia coseno en SQL). Cuando no la admite, un motor integrado calcula la similitud por sí mismo. Si la vía nativa falla por cualquier motivo, la búsqueda recurre al motor integrado para esa consulta. La recuperación nunca se interrumpe por culpa de la capa vectorial.
Siempre al día, sin pagar dos veces

  • Cuando alguien guarda un artículo de la base de conocimiento, un playbook, un documento, un producto, una solución o una categoría, OPS lo vuelve a indexar poco después. Al eliminarlo, se eliminan sus vectores.
  • Solo se vuelven a convertir en embeddings los pasajes cuyo contenido ha cambiado; cada fragmento lleva un hash de su contenido. Un texto idéntico reutiliza un vector existente en lugar de pagar por uno nuevo.
  • El vector de una pregunta de búsqueda también se guarda en caché: la misma pregunta se convierte en embedding una sola vez.
  • Durante una importación de datos no se pone nada en cola; una reconciliación nocturna se pone al día después.

Dónde lo nota su equipo

  • Los colegas de IA buscan mejor. Sus búsquedas en la base de conocimiento, los playbooks, la documentación y los productos muestran primero las coincidencias semánticas y mantienen detrás las coincidencias por palabras clave.
  • Contenido relacionado en un ticket. Para la categoría del ticket, un colega de IA recibe el contenido que usted vinculó, las soluciones que resolvieron tickets similares anteriormente y los documentos más cercanos en significado al título del ticket.
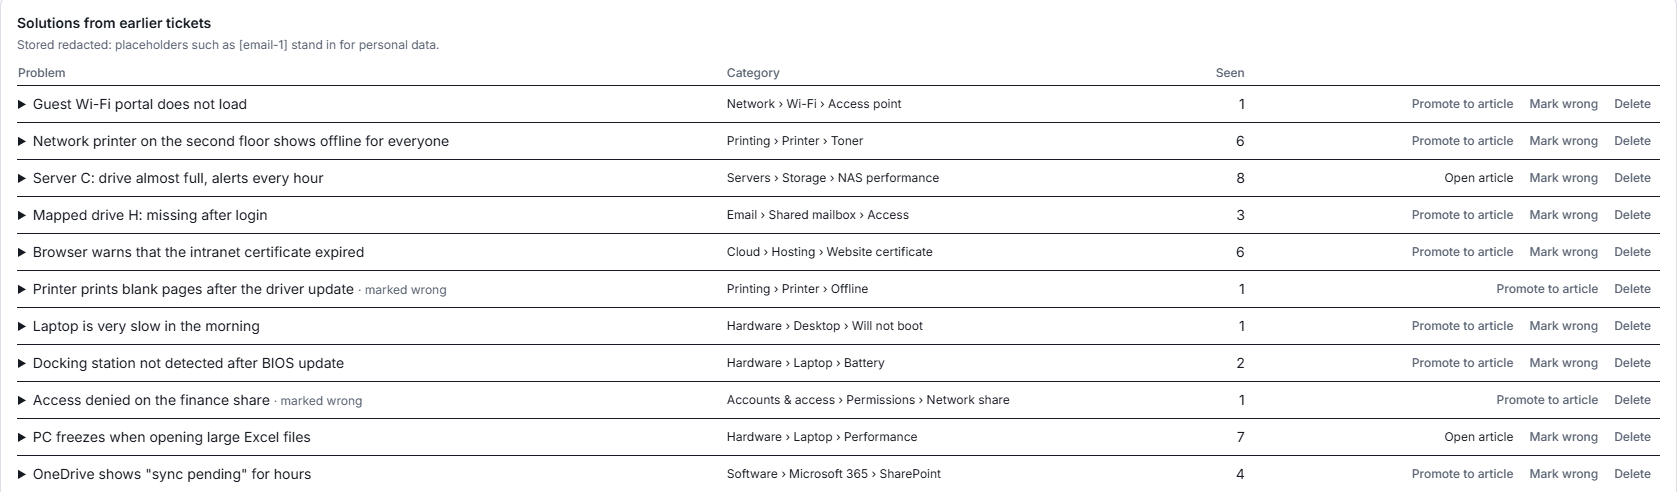
  • Una memoria de soluciones más limpia. Una solución nueva casi idéntica (similitud coseno de 0,92 o más) a otra ya almacenada para la misma categoría se trata como la misma solución, para que su lista no se llene de duplicados.

La lista de soluciones en la página de memoria de IA de Xcellerate OPS, con Promover a artículo, Marcar como incorrecta y Eliminar en cada fila Captura de pantalla real de nuestro entorno de demostración, con datos ficticios.

Privacidad y control

  • El texto se enmascara antes de convertirse en embedding y las soluciones almacenadas conservan los marcadores.
  • El índice está en la propia base de datos de su espacio de trabajo; la documentación de un cliente está limitada a ese cliente.
  • Un responsable de equipo puede marcar una solución como incorrecta (sale del índice) o eliminarla; al eliminar cualquier elemento indexado se eliminan sus vectores.
  • El interruptor de emergencia de la IA detiene los embeddings junto con todas las demás llamadas a la IA.
  • El Centro de transparencia de IA recoge la memoria de IA en su registro del Reglamento de IA (AI Act) («se conserva hasta que se borra o se elimina; se almacena enmascarada»), y Configuración → Memoria de IA muestra lo que contiene la memoria. Más información sobre el registro en nuestra página sobre gobernanza de la IA.

La fila de la memoria de IA en el registro del Reglamento de IA de Xcellerate OPS: riesgo mínimo, solo de carácter consultivo, se conserva hasta que se borra o se elimina, se almacena enmascarada Captura de pantalla real de nuestro entorno de demostración; una columna aparece difuminada.

Cuánto cuesta

Los embeddings consumen créditos de IA en la categoría de memoria de IA, y cada llamada se registra como cualquier otra acción de IA. Como los pasajes sin cambios y las preguntas repetidas nunca se convierten en embeddings dos veces, el coste depende de cuánto cambia su conocimiento, no de cuántas veces busca su equipo. La página Oversight del Centro de transparencia de IA muestra lo que ha ahorrado la reutilización.

Primeros pasos

No hay nada que activar: la indexación empieza sola y se mantiene al día a medida que cambia su contenido. Cuanto más documente en artículos, playbooks y documentación de clientes, y cuantos más tickets resuelva, más material tendrán sus colegas de IA para trabajar.

Si es nuevo en Xcellerate OPS, la página de la función de colegas de IA explica qué hacen los colegas, y nuestro artículo sobre cómo cada ticket que cierra abarata el siguiente trata la memoria de IA de la que forma parte este índice.

Empiece gratis

Preguntas frecuentes

¿Qué es RAG, en pocas palabras?
La generación aumentada por recuperación significa que la IA busca primero los pasajes más relevantes en su propio contenido y luego redacta su respuesta a partir de ellos, como en un examen a libro abierto.
¿Tengo que activar algo?
No. La indexación empieza sola y se mantiene al día a medida que se guardan o eliminan artículos, playbooks, documentación, productos, soluciones y categorías.
¿Qué modelo de embeddings utiliza Xcellerate OPS?
El modelo mistral-embed de Mistral, que produce vectores de 1.024 dimensiones. El texto se enmascara antes de enviarse.
¿Sigue funcionando la búsqueda por palabras clave?
Sí. Cada búsqueda combina la búsqueda por palabras clave y la vectorial y fusiona los resultados. Si la vía vectorial falla, la búsqueda por palabras clave sigue respondiendo.
¿Puede la documentación de un cliente llegar a otro cliente?
No. La documentación que pertenece a un cliente solo se devuelve cuando la IA trabaja para ese cliente.
Fuentes: Código y documentación del producto Xcellerate OPS (RMM Labs, octubre de 2026)

¿Listo para resolver el cumplimiento del registro horario?

Xcellerate OPS cubre los requisitos belgas de registro horario de 2027 de serie — sin módulo adicional.
Artículos relacionados