6 oct. 2026
Xcellerate OPS indexe en vecteurs votre base de connaissances, vos playbooks, votre documentation et vos tickets résolus. RAG, embeddings, ce que nous avons construit et ce que votre équipe verra.
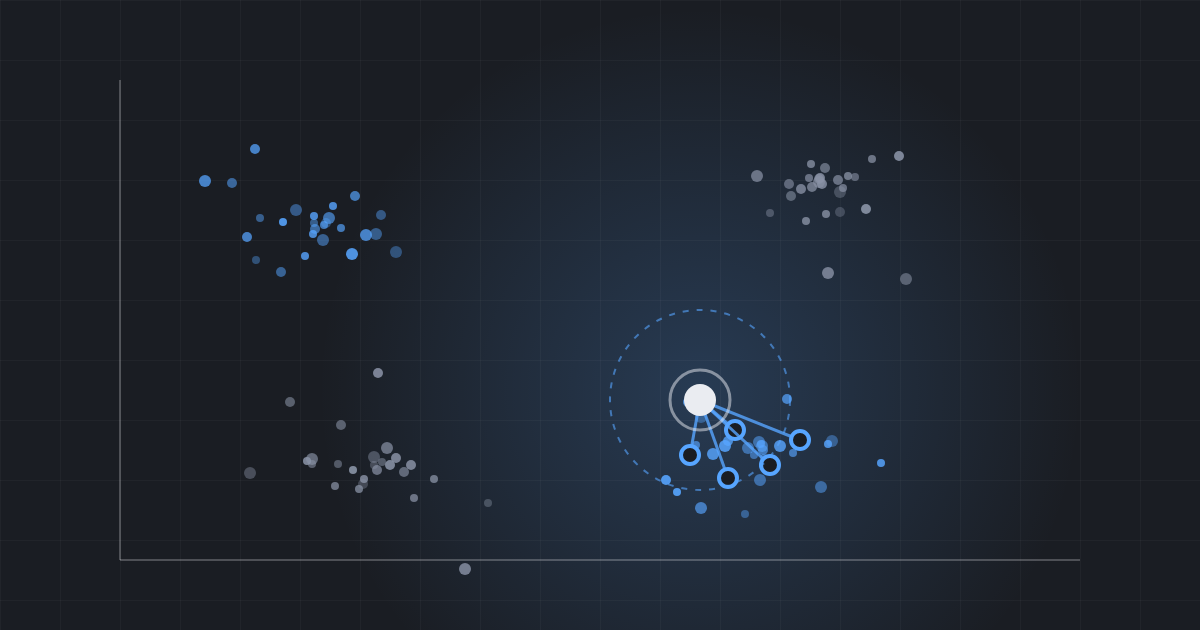
En bref — Xcellerate OPS utilise désormais la génération augmentée par récupération (RAG) en s'appuyant sur un index vectoriel de vos propres connaissances. Votre base de connaissances, vos playbooks, votre documentation client, votre catalogue de produits, vos solutions relues et vos catégories de tickets sont transformés en embeddings par le modèle d'embedding de Mistral, puis stockés dans la base de données propre à votre espace de travail. Lorsqu'un collègue IA fait une recherche, OPS combine la recherche classique par mots-clés et la recherche par le sens : il trouve l'article qui répond à la question, même quand le ticket emploie d'autres mots. Le texte est caviardé avant d'être transformé en embedding, la documentation propre à un client n'apparaît que pour ce client, et la recherche par mots-clés continue de fonctionner si quoi que ce soit échoue du côté vectoriel.
Un grand modèle de langage en sait beaucoup sur le monde, mais rien sur vos clients, vos imprimantes ou le contournement que votre technicien senior a trouvé au printemps dernier. Posez-lui une question sur votre environnement et il répondra quand même, parfois de manière convaincante… et fausse.
La génération augmentée par récupération (RAG, pour retrieval-augmented generation) règle ce problème en scindant le travail en deux :
Voyez cela comme un examen à livre ouvert. Le modèle continue de raisonner et de rédiger, mais il travaille à partir de votre livre plutôt que de mémoire. La réponse s'améliore dès que la bonne page est trouvée, et vous pouvez voir de quelle page il s'agit.
La partie difficile du RAG, c'est la première étape : trouver le bon passage. La recherche classique compare des mots. Un ticket qui dit « personne au deuxième étage ne peut imprimer » ne trouvera pas un article de base de connaissances intitulé « Le spouleur d'impression se bloque après une mise à jour du pilote », alors que c'est exactement la solution.
Les embeddings résolvent ce problème. Un modèle d'embedding lit un morceau de texte et le transforme en une longue liste de nombres, un vecteur, qui capture ce que le texte veut dire plutôt que les mots qu'il utilise. Les textes qui parlent de la même chose se retrouvent proches les uns des autres dans cet espace, même s'ils n'ont aucun mot en commun. « Impossible d'imprimer », « imprimante hors ligne pour tout le monde » et « spouleur bloqué » se retrouvent côte à côte ; « facture en retard » atterrit bien plus loin.
Une base de données vectorielle (ou index vectoriel) stocke ces vecteurs et répond très rapidement à une seule question : quels vecteurs stockés sont les plus proches de celui-ci ? La proximité se mesure généralement avec la similarité cosinus, c'est-à-dire l'angle entre deux vecteurs. La requête de recherche est transformée en vecteur avec le même modèle, et les passages les plus proches sont les candidats que le modèle de langage pourra lire.
OPS tient un index sémantique de six types de contenu :
Chaque élément est découpé en fragments qui se chevauchent, d'environ 800 tokens chacun : un long article devient ainsi plusieurs passages consultables, et c'est le meilleur passage qui l'emporte. L'index se trouve dans la base de données propre à votre espace de travail, à côté des données qu'il décrit. La documentation qui appartient à un client n'est renvoyée que lorsque l'IA travaille pour ce client.
Les vecteurs sont produits par le modèle d'embedding de Mistral, mistral-embed, qui génère des vecteurs de 1 024 dimensions. Deux garde-fous comptent ici :
OPS ne s'appuie jamais uniquement sur les vecteurs. Chaque recherche emprunte deux chemins :
Les deux listes de résultats sont fusionnées par reciprocal rank fusion (fusion par rang réciproque) : un élément bien classé dans l'une des deux listes remonte, un élément bien classé dans les deux remonte le plus. Les correspondances vectorielles trop faibles (similarité cosinus inférieure à 0,2) sont écartées comme du bruit, et chaque document n'apparaît qu'une fois, représenté par son meilleur passage. Un code produit ou un numéro d'erreur que seule la recherche par mots-clés repère n'est jamais perdu, et un symptôme reformulé que seul le sens permet de repérer est trouvé lui aussi.
Lorsque la base de données prend en charge la recherche vectorielle native, OPS l'utilise (distance cosinus en SQL). Dans le cas contraire, un moteur intégré calcule lui-même la similarité. Si le chemin natif échoue pour une raison quelconque, la recherche se rabat sur le moteur intégré pour cette requête. La récupération ne tombe jamais en panne à cause de la couche vectorielle.
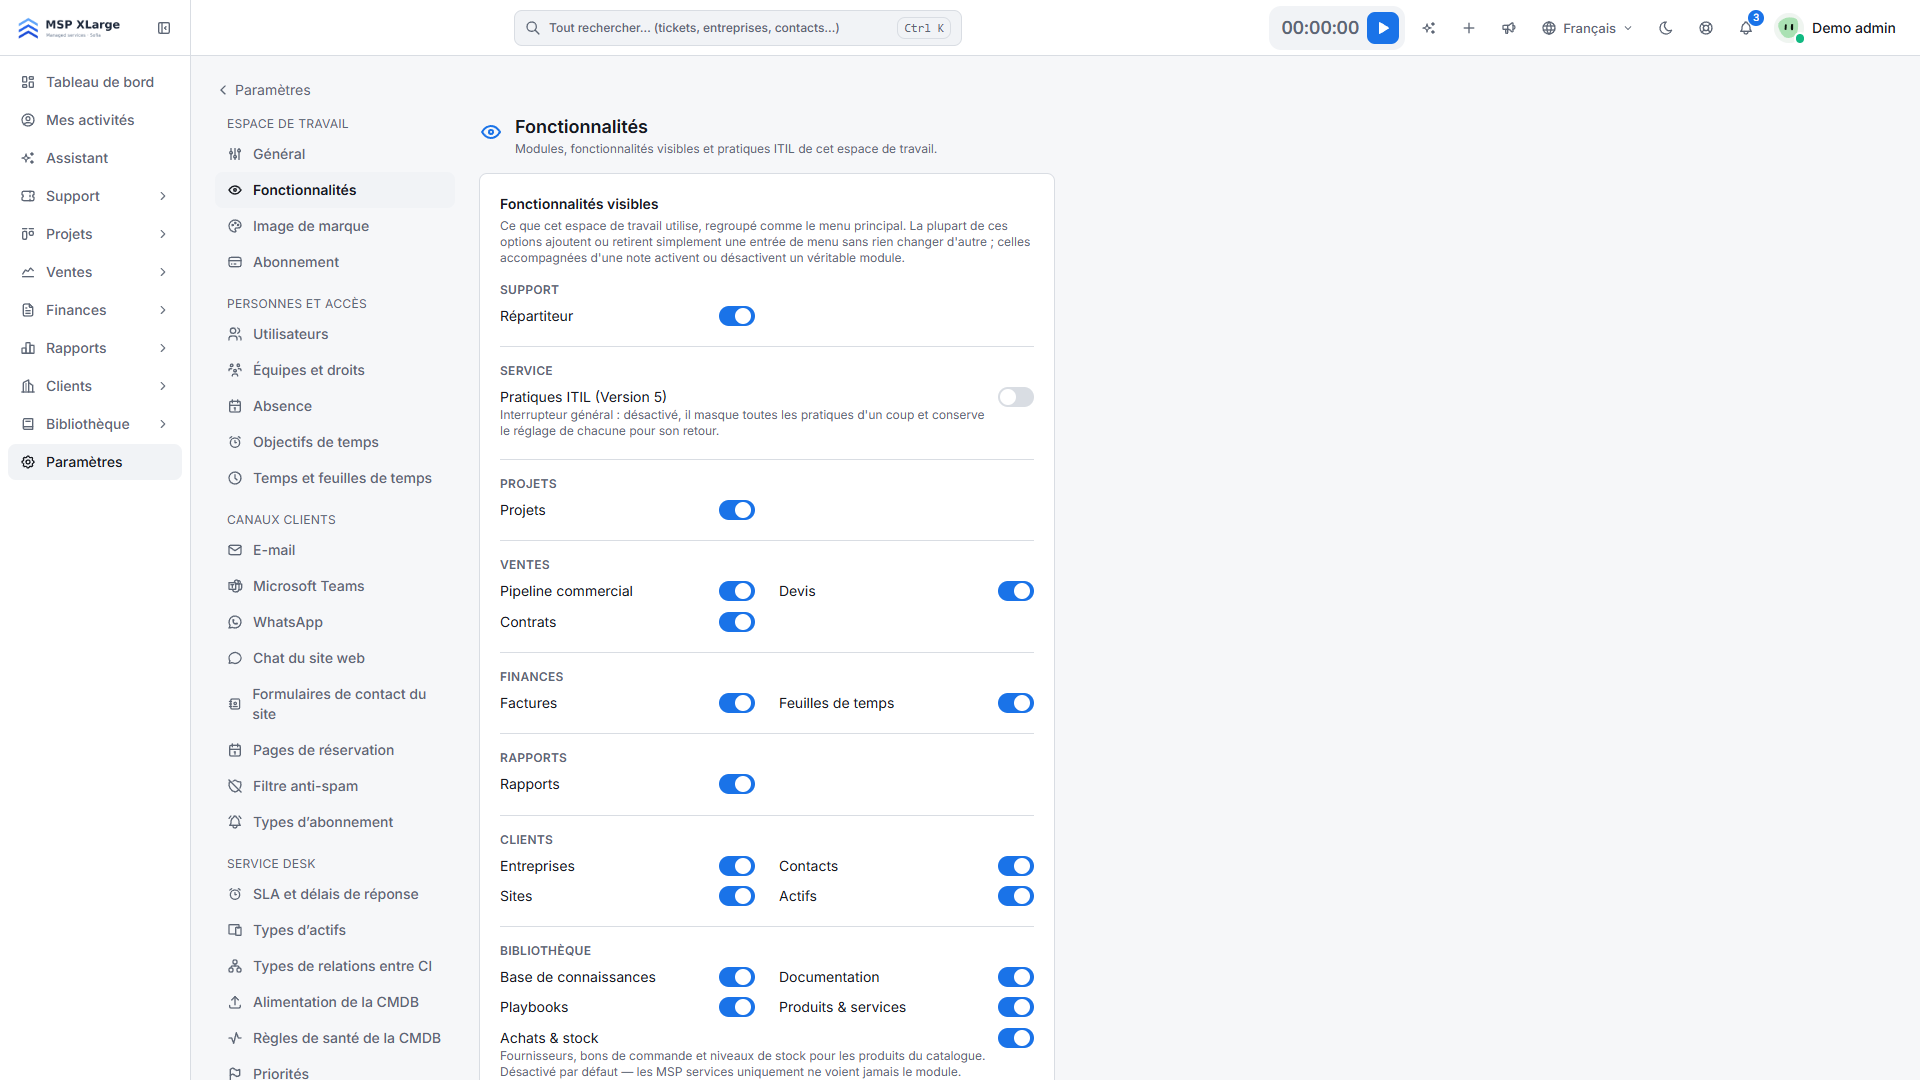
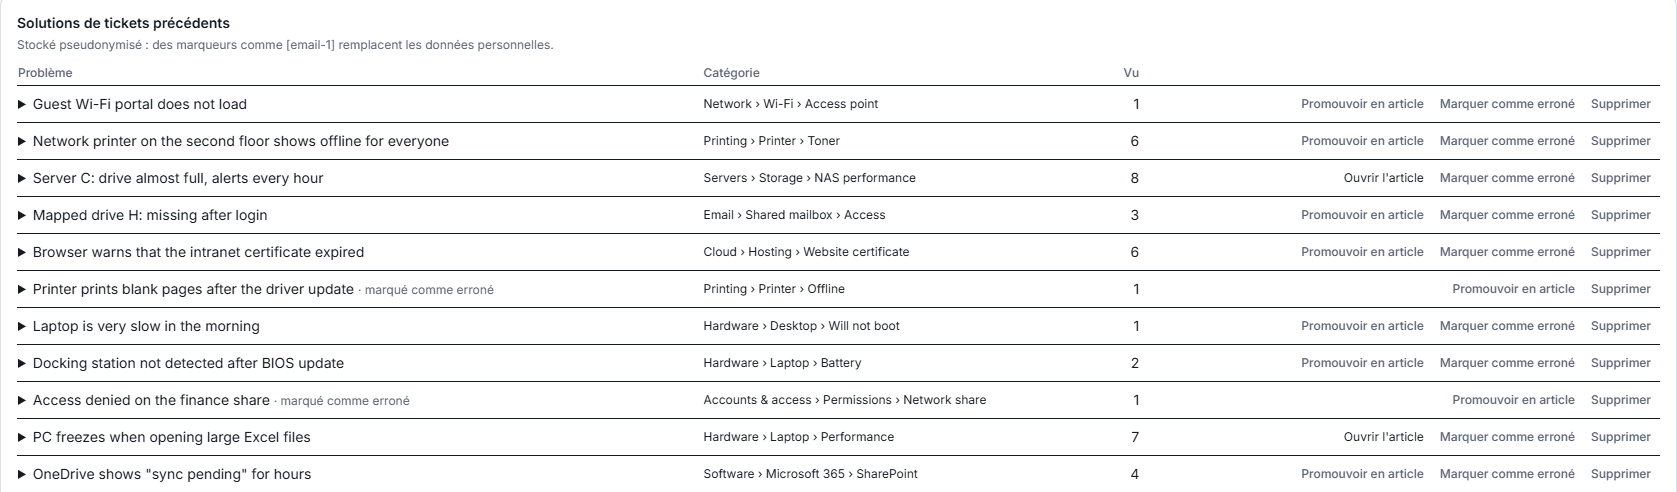 Capture d'écran réelle de notre environnement de démonstration, avec des données fictives.
 Capture d'écran réelle de notre environnement de démonstration ; une colonne est floutée.
Les embeddings consomment des crédits IA dans la catégorie Mémoire de l'IA, et chaque appel est journalisé comme n'importe quelle autre action IA. Comme les passages inchangés et les questions répétées ne sont jamais transformés deux fois en embeddings, le coût suit le rythme auquel vos connaissances évoluent, et non la fréquence des recherches de votre équipe. La page Oversight de l'AI Transparency Center montre ce que la réutilisation vous a fait économiser.
Il n'y a rien à activer : l'indexation démarre d'elle-même et suit l'évolution de votre contenu. Plus vous consignez de choses dans vos articles, vos playbooks et votre documentation client, et plus vous résolvez de tickets, plus vos collègues IA ont de matière sur laquelle s'appuyer.
Si vous découvrez Xcellerate OPS, la page consacrée aux collègues IA explique ce qu'ils font, et notre article Chaque ticket que vous clôturez rend le suivant moins cher présente la mémoire de l'IA dont cet index fait partie.
Xcellerate OPS couvre les exigences belges d'enregistrement du temps de 2027 d'origine — sans module supplémentaire.