6 жовт. 2026 р.
Xcellerate OPS тепер індексує вашу базу знань, плейбуки, документацію та вирішені тікети як вектори. Що таке RAG і ембединги, що ми створили і що помітить ваша команда.
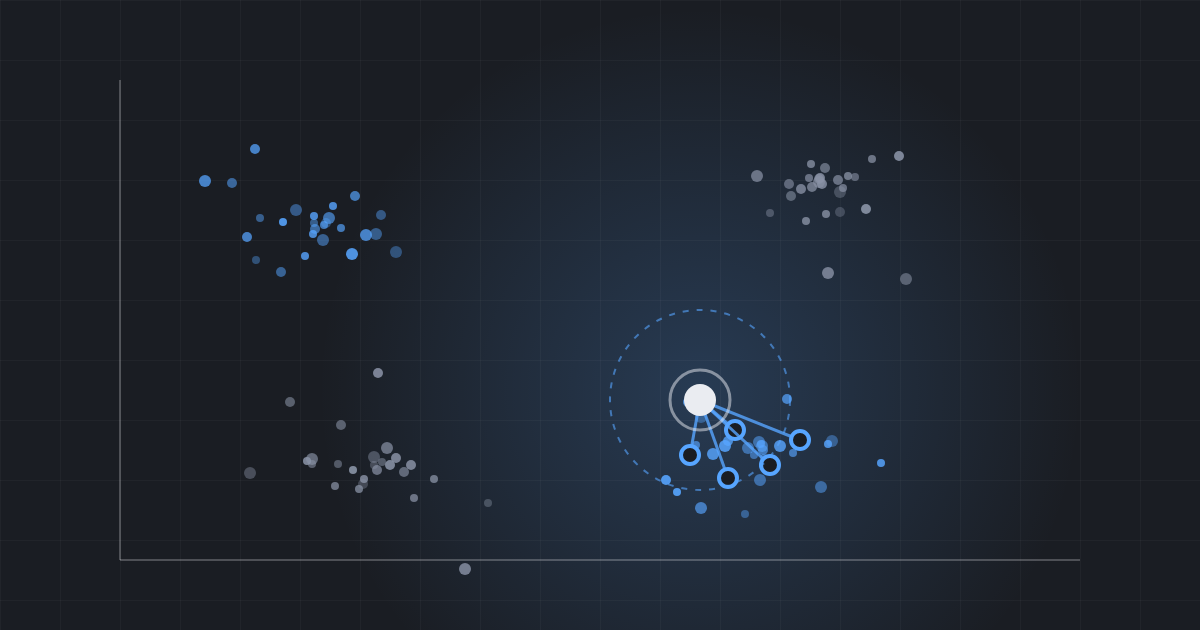
Коротко: Xcellerate OPS тепер застосовує генерацію з доповненим пошуком (RAG) поверх векторного індексу ваших власних знань. Ваша база знань, плейбуки, документація клієнтів, каталог продуктів, перевірені рішення та категорії тікетів перетворюються на ембединги за допомогою моделі ембедингів від Mistral і зберігаються у власній базі даних вашого робочого простору. Коли AI-колега шукає інформацію, OPS поєднує класичний пошук за ключовими словами з пошуком за змістом, тож знаходить статтю, яка відповідає на запитання, навіть якщо в тікеті вжито зовсім інші слова. Текст очищується від чутливих даних ще до створення ембедингів, документація конкретного клієнта показується лише для цього клієнта, а пошук за ключовими словами продовжує працювати, якщо у векторному шляху щось дає збій.
Велика мовна модель знає багато про світ, але нічого не знає про ваших клієнтів, ваші принтери чи обхідне рішення, яке ваш старший технік знайшов минулої весни. Поставте їй запитання про своє середовище — і вона однаково відповість, іноді переконливо й неправильно.
Генерація з доповненим пошуком (RAG, retrieval-augmented generation) розв'язує це, розділяючи роботу на два кроки:
Уявіть собі іспит із відкритою книгою. Модель і далі міркує та пише сама, але працює з вашою книгою, а не з пам'яті. Відповідь стає кращою, щойно знайдено потрібну сторінку, — і ви бачите, яка саме це сторінка.
Найскладніше в RAG — перший крок: знайти потрібний фрагмент. Класичний пошук зіставляє слова. Тікет «на другому поверсі ніхто не може друкувати» не знайде статтю бази знань під назвою «Служба друку зависає після оновлення драйвера», хоча саме вона містить розв'язання.
Цю проблему розв'язують ембединги. Модель ембедингів читає фрагмент тексту й перетворює його на довгий список чисел — вектор, який передає зміст тексту, а не те, які слова в ньому вжито. Тексти про одне й те саме опиняються поруч у цьому просторі, навіть якщо не мають жодного спільного слова. «Не можу друкувати», «принтер офлайн для всіх» і «служба друку зависла» лежать близько одне до одного; «прострочений рахунок» — далеко.
Векторна база даних (або векторний індекс) зберігає ці вектори й дуже швидко відповідає на одне запитання: які збережені вектори найближчі до цього? Близькість зазвичай вимірюють косинусною подібністю — кутом між двома векторами. Пошуковий запит перетворюється на вектор тією самою моделлю, а найближчі фрагменти стають кандидатами, які отримує для читання мовна модель.
OPS веде семантичний індекс шести видів вмісту:
Кожен елемент розбивається на фрагменти приблизно по 800 токенів, що перекриваються, тож довга стаття стає кількома фрагментами для пошуку, і перемагає найкращий із них. Індекс зберігається у власній базі даних вашого робочого простору, поруч із даними, які він описує. Документація, що належить одному клієнтові, повертається лише тоді, коли AI працює для цього клієнта.
Вектори створює модель ембедингів від Mistral — mistral-embed, яка генерує 1 024-вимірні вектори. Тут важливі два запобіжники:
OPS ніколи не покладається лише на вектори. Кожен пошук іде двома шляхами:
Два списки результатів об'єднуються методом reciprocal rank fusion (злиття за оберненим рангом): елемент, який має високе місце в будь-якому зі списків, піднімається вгору, а той, що високо в обох, — найвище. Надто слабкі векторні збіги (косинусна подібність нижче 0,2) відкидаються як шум, і кожен документ з'являється один раз — у вигляді свого найкращого фрагмента. Код продукту чи номер помилки, які ловить лише пошук за ключовими словами, ніколи не губляться, а перефразований симптом, який розпізнає лише пошук за змістом, теж знаходиться.
Там, де база даних підтримує нативний векторний пошук, OPS використовує його (косинусна відстань у SQL). Там, де ні, вбудований механізм обчислює подібність самостійно. Якщо нативний шлях із будь-якої причини дає збій, пошук для цього запиту переходить на вбудований механізм. Векторний шар ніколи не ламає пошук.
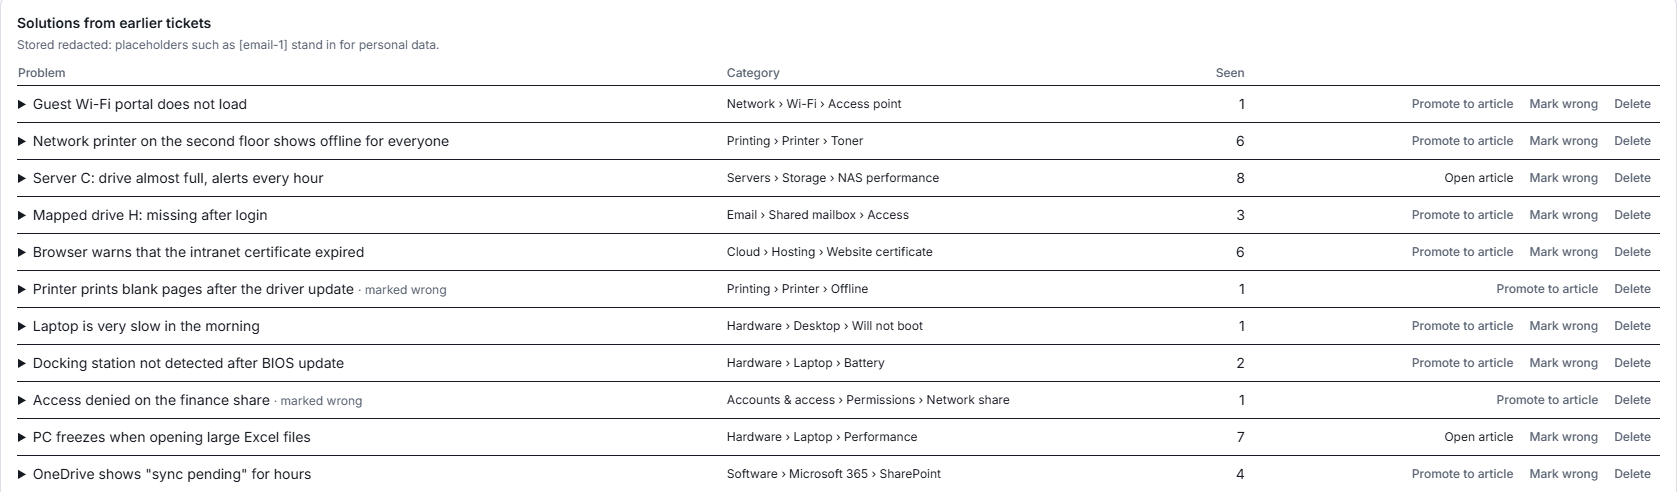 Справжній знімок екрана з нашого демо-середовища з вигаданими даними.
 Справжній знімок екрана з нашого демо-середовища; одну колонку розмито.
Створення ембедингів використовує AI-кредити в категорії AI-пам'яті, і кожен виклик фіксується в журналі, як і будь-яка інша дія AI. Оскільки для незмінених фрагментів і повторюваних запитань ембединги ніколи не створюються двічі, витрати залежать від того, наскільки змінюються ваші знання, а не від того, як часто шукає ваша команда. Сторінка Oversight у Центрі прозорості AI показує, скільки заощадило повторне використання.
Нічого вмикати не потрібно: індексування запускається саме й не відстає від змін вашого вмісту. Що більше ви записуєте у статті, плейбуки та документацію клієнтів і що більше тікетів вирішуєте, то більше матеріалу мають для роботи ваші AI-колеги.
Якщо ви тільки знайомитеся з Xcellerate OPS, сторінка про AI-колег пояснює, що вони роблять, а наша стаття про те, як кожен закритий тікет робить наступний дешевшим, розповідає про AI-пам'ять, частиною якої є цей індекс.
Xcellerate OPS покриває бельгійські вимоги до обліку робочого часу з 2027 року за замовчуванням — без додаткового модуля.