RMM Labs
7 Min. Lesezeit 7. Oktober 2026 Von Fred

RAG in Xcellerate OPS: KI, die nach Bedeutung sucht

Xcellerate OPS indexiert Wissensdatenbank, Playbooks, Doku und gelöste Tickets als Vektoren. Was RAG und Embeddings sind, was wir gebaut haben und was Ihr Team merkt.
RAG in Xcellerate OPS: KI, die nach Bedeutung sucht

Kurz gesagt Xcellerate OPS nutzt jetzt Retrieval-Augmented Generation (RAG) auf Basis eines Vektorindex Ihres eigenen Wissens. Ihre Wissensdatenbank, Ihre Playbooks, Ihre Kundendokumentation, Ihr Produktkatalog, Ihre geprüften Lösungen und Ihre Ticketkategorien werden mit dem Embedding-Modell von Mistral in Embeddings umgewandelt und in der eigenen Datenbank Ihres Workspace gespeichert. Wenn ein KI-Kollege sucht, kombiniert OPS die klassische Stichwortsuche mit der Suche nach Bedeutung. So findet er den Artikel, der die Frage beantwortet, auch wenn im Ticket ganz andere Wörter stehen. Texte werden geschwärzt, bevor sie eingebettet werden, kundenspezifische Dokumentation erscheint nur für genau diesen Kunden, und die Stichwortsuche funktioniert weiter, falls im Vektorpfad etwas ausfällt.

Was ist RAG?

Ein großes Sprachmodell weiß viel über die Welt, aber nichts über Ihre Kunden, Ihre Drucker oder den Workaround, den Ihr erfahrener Techniker im letzten Frühjahr gefunden hat. Stellen Sie ihm eine Frage zu Ihrer Umgebung, antwortet es trotzdem, manchmal überzeugend und falsch.

Retrieval-Augmented Generation (RAG), also durch Abruf ergänzte Textgenerierung, löst das, indem sie die Arbeit in zwei Schritte teilt:

  1. Abrufen. Bevor das Modell antwortet, sucht das System in Ihren eigenen Inhalten die Passagen, die für die Frage am relevantesten sind.
  2. Generieren. Das Modell schreibt seine Antwort und nutzt diese Passagen als Quellenmaterial.

Stellen Sie es sich wie eine Prüfung mit offenem Buch vor. Das Modell übernimmt weiterhin das Denken und das Schreiben, arbeitet aber mit Ihrem Buch statt aus dem Gedächtnis. Die Antwort wird besser, sobald die richtige Seite gefunden ist, und Sie sehen, welche Seite das war.

Was sind Embeddings und eine Vektordatenbank?

Der schwierige Teil von RAG ist der erste Schritt: die richtige Passage zu finden. Die klassische Suche vergleicht Wörter. Ein Ticket mit dem Text „im zweiten Stock kann niemand drucken“ findet keinen Artikel der Wissensdatenbank mit dem Titel „Druckwarteschlange hängt nach Treiberupdate“, obwohl genau das die Lösung ist.

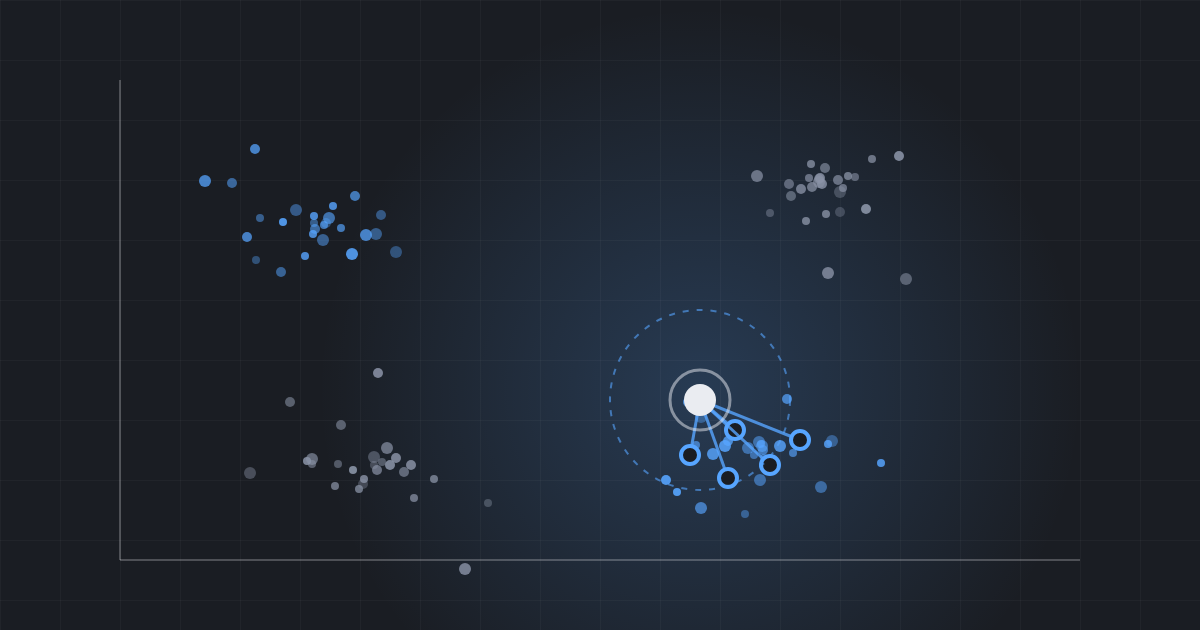
Embeddings lösen dieses Problem. Ein Embedding-Modell liest ein Stück Text und macht daraus eine lange Liste von Zahlen, einen Vektor, der erfasst, was der Text bedeutet, und nicht, welche Wörter er verwendet. Texte über dasselbe Thema liegen in diesem Raum nahe beieinander, auch wenn sie kein einziges Wort gemeinsam haben. „Kann nicht drucken“, „Drucker für alle offline“ und „Spooler hängt“ landen nah beieinander; „Rechnung überfällig“ landet weit entfernt.

Eine Vektordatenbank (oder ein Vektorindex) speichert diese Vektoren und beantwortet eine Frage sehr schnell: Welche gespeicherten Vektoren liegen diesem am nächsten? Die Nähe wird meist mit der Kosinus-Ähnlichkeit gemessen, also dem Winkel zwischen zwei Vektoren. Die Suchanfrage wird mit demselben Modell in einen Vektor umgewandelt, und die nächstgelegenen Passagen sind die Kandidaten, die das Sprachmodell zu lesen bekommt.

Warum das für einen Servicedesk wichtig ist

  • Menschen beschreiben Probleme in ihren eigenen Worten. Kunden schreiben Symptome, Techniker schreiben Lösungen. Die Suche nach Bedeutung schlägt die Brücke zwischen beidem.
  • Ihr Wissen ist verstreut. Artikel der Wissensdatenbank, Playbooks, Dokumentation pro Kunde, Produktnotizen und die Lösungen, die Ihr Team bereits gefunden hat. Mit RAG kann ein KI-Kollege all das genau in dem Moment lesen, in dem er es braucht.
  • Belegte Antworten lassen sich überprüfen. Wenn eine Antwort auf einem benannten Artikel oder Playbook beruht, kann ein Techniker die Quelle öffnen und nachprüfen. Das ist der Unterschied zwischen einem Assistenten, dem Sie vertrauen können, und einem, den Sie jedes Mal von Grund auf kontrollieren müssen.
  • Weniger Raten, weniger wiederholte Fragen. Wenn die KI die frühere Lösung findet, muss der erfahrene Techniker nicht zum dritten Mal in diesem Monat dieselbe Frage beantworten.

Was wir in Xcellerate OPS eingebaut haben

Ein semantischer Index pro Workspace

OPS führt einen semantischen Index über sechs Arten von Inhalten:

  • Artikel der Wissensdatenbank (Ordner werden übersprungen);
  • Playbooks, einschließlich ihres Hinweises „gilt, wenn“ und der Vorgehensweise;
  • Dokumentation, die Sie pro Kunde führen;
  • Produkte aus Ihrem Katalog, mit ihrer Beschreibung und ihren KI-Anweisungen;
  • Lösungen, die aus gelösten Tickets destilliert wurden (eine Lösung, die eine Teamleitung als falsch markiert hat, bleibt außen vor);
  • Ticketkategorien und die KI-Hinweise, die Sie dafür geschrieben haben.

Jedes Element wird in überlappende Abschnitte von etwa 800 Tokens aufgeteilt. Ein langer Artikel wird so zu mehreren durchsuchbaren Passagen, und die beste Passage gewinnt. Der Index liegt in der eigenen Datenbank Ihres Workspace, direkt neben den Daten, die er beschreibt. Dokumentation, die zu einem bestimmten Kunden gehört, wird nur zurückgegeben, wenn die KI für genau diesen Kunden arbeitet.

Embeddings von Mistral

Die Vektoren erzeugt das Embedding-Modell von Mistral, mistral-embed, das Vektoren mit 1.024 Dimensionen liefert. Zwei Schutzmechanismen sind dabei wichtig:

  • Zuerst geschwärzt. Jeder Text durchläuft denselben Schwärzungsschritt wie jeder andere KI-Aufruf in OPS, bevor er die Plattform verlässt. Personenbezogene Daten wie E-Mail-Adressen werden durch Platzhalter ersetzt.
  • Ein Modell, ein Raum. Vektoren aus zwei verschiedenen Modellen lassen sich nicht vergleichen. Falls jemals ein Ersatzanbieter nötig ist, weicht OPS nur auf einen Anbieter aus, der dasselbe Modell bereitstellt. So wird der Index nie vermischt.

Hybride Suche: Stichwort und Bedeutung zusammen

OPS verlässt sich nie allein auf Vektoren. Jede Suche läuft über zwei Wege:

  1. Stichwortsuche in Titeln und extrahierten Schlüsselwörtern, die immer läuft;
  2. Vektorsuche nach den Passagen, die der Frage inhaltlich am nächsten sind.

Die beiden Ergebnislisten werden mit Reciprocal Rank Fusion zusammengeführt: Ein Element, das in einer der beiden Listen weit oben steht, steigt auf; ein Element, das in beiden weit oben steht, steigt am stärksten. Zu schwache Vektortreffer (Kosinus-Ähnlichkeit unter 0,2) werden als Rauschen verworfen, und jedes Dokument erscheint nur einmal, vertreten durch seine beste Passage. Ein Produktcode oder eine Fehlernummer, die nur die Stichwortsuche erfasst, geht nie verloren, und ein umschriebenes Symptom, das nur die Bedeutungssuche erkennt, wird ebenfalls gefunden.

Native Vektorsuche, mit Sicherheitsnetz

Wo die Datenbank native Vektorsuche unterstützt, nutzt OPS sie (Kosinus-Distanz in SQL). Wo nicht, berechnet eine eingebaute Engine die Ähnlichkeit selbst. Schlägt der native Weg aus irgendeinem Grund fehl, weicht die Suche für diese Anfrage auf die eingebaute Engine aus. Der Abruf scheitert nie an der Vektorschicht.
Immer aktuell, nie doppelt bezahlt

  • Wenn jemand einen Artikel der Wissensdatenbank, ein Playbook, ein Dokument, ein Produkt, eine Lösung oder eine Kategorie speichert, indexiert OPS das Element kurz danach neu. Beim Löschen werden auch seine Vektoren entfernt.
  • Nur Passagen, deren Inhalt sich geändert hat, werden erneut eingebettet; jeder Abschnitt trägt einen Hash seines Inhalts. Identischer Text verwendet einen vorhandenen Vektor wieder, statt für einen neuen zu bezahlen.
  • Auch der Vektor einer Suchanfrage wird zwischengespeichert: Dieselbe Frage wird nur einmal eingebettet.
  • Während eines Datenimports wird nichts in die Warteschlange gestellt; ein nächtlicher Abgleich holt danach alles nach.

Wo Ihr Team es bemerkt

  • KI-Kollegen suchen besser. Ihre Abfragen in Wissensdatenbank, Playbooks, Dokumentation und Produkten zeigen die semantischen Treffer zuerst und behalten die Stichworttreffer dahinter.
  • Verwandte Inhalte zu einem Ticket. Für die Kategorie des Tickets erhält ein KI-Kollege die Inhalte, die Sie verknüpft haben, die Lösungen, mit denen ähnliche Tickets früher gelöst wurden, und die Dokumente, die dem Tickettitel inhaltlich am nächsten sind.
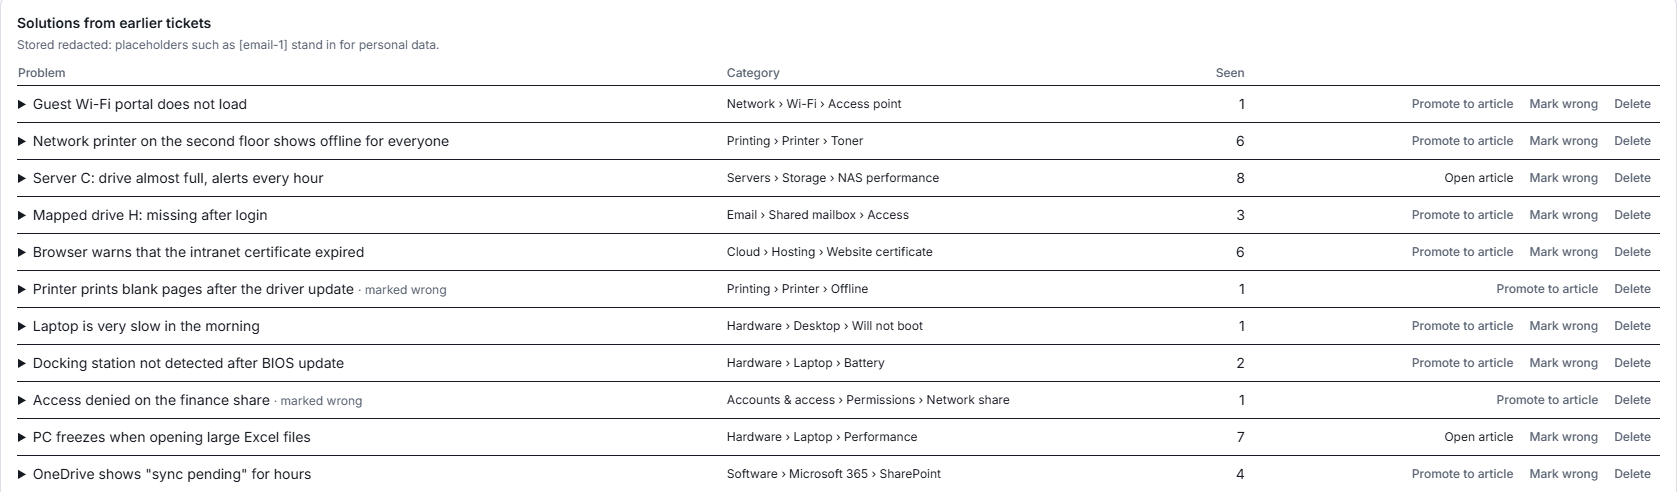
  • Ein aufgeräumteres Lösungsgedächtnis. Eine neue Lösung, die nahezu identisch (Kosinus-Ähnlichkeit von 0,92 oder mehr) mit einer bereits gespeicherten Lösung derselben Kategorie ist, wird als dieselbe Lösung behandelt. So füllt sich Ihre Liste nicht mit Duplikaten.

Die Lösungsliste auf der Seite KI-Gedächtnis in Xcellerate OPS, mit „Als Artikel übernehmen“, „Als falsch markieren“ und „Löschen“ in jeder Zeile Echter Screenshot aus unserer Demo-Umgebung, mit fiktiven Daten.

Datenschutz und Kontrolle

  • Texte werden geschwärzt, bevor sie eingebettet werden, und die gespeicherten Lösungen behalten die Platzhalter.
  • Der Index liegt in der eigenen Datenbank Ihres Workspace; Kundendokumentation ist auf diesen Kunden beschränkt.
  • Eine Teamleitung kann eine Lösung als falsch markieren (dann verlässt sie den Index) oder sie löschen; das Löschen eines indexierten Elements entfernt auch seine Vektoren.
  • Der KI-Notschalter stoppt das Einbetten zusammen mit jedem anderen KI-Aufruf.
  • Das KI-Transparenzcenter führt das KI-Gedächtnis in Ihrem AI-Act-Register auf („aufbewahrt bis zur Löschung; geschwärzt gespeichert“), und unter Einstellungen → KI-Gedächtnis sehen Sie, was das Gedächtnis enthält. Mehr zum Register auf unserer Seite zur KI-Governance.

Die Zeile KI-Gedächtnis im AI-Act-Register von Xcellerate OPS: minimales Risiko, nur beratend, aufbewahrt bis zur Löschung, geschwärzt gespeichert Echter Screenshot aus unserer Demo-Umgebung; eine Spalte ist unscharf gemacht.

Was es kostet

Das Einbetten verbraucht KI-Credits in der Kategorie KI-Gedächtnis, und jeder Aufruf wird wie jede andere KI-Aktion protokolliert. Weil unveränderte Passagen und wiederholte Fragen nie zweimal eingebettet werden, richten sich die Kosten danach, wie stark sich Ihr Wissen ändert, und nicht danach, wie oft Ihr Team sucht. Die Oversight-Seite im KI-Transparenzcenter zeigt, was die Wiederverwendung eingespart hat.

So starten Sie

Sie müssen nichts einschalten: Die Indexierung startet von selbst und bleibt auf dem neuesten Stand, während sich Ihre Inhalte ändern. Je mehr Sie in Artikeln, Playbooks und Kundendokumentation festhalten und je mehr Tickets Sie lösen, desto mehr haben Ihre KI-Kollegen, womit sie arbeiten können.

Wenn Sie Xcellerate OPS noch nicht kennen, erklärt die Funktionsseite zu KI-Kollegen, was die Kollegen tun, und unser Artikel darüber, wie jedes Ticket, das Sie schließen, das nächste günstiger macht, beschreibt das KI-Gedächtnis, zu dem dieser Index gehört.

Kostenlos starten

Häufig gestellte Fragen

Was ist RAG, einfach erklärt?
Retrieval-Augmented Generation bedeutet, dass die KI zuerst die relevantesten Passagen in Ihren eigenen Inhalten nachschlägt und ihre Antwort dann daraus schreibt, wie bei einer Prüfung mit offenem Buch.
Muss ich etwas einschalten?
Nein. Die Indexierung startet von selbst und bleibt aktuell, wenn Artikel, Playbooks, Dokumentation, Produkte, Lösungen und Kategorien gespeichert oder gelöscht werden.
Welches Embedding-Modell nutzt Xcellerate OPS?
Das Modell mistral-embed von Mistral, das Vektoren mit 1.024 Dimensionen erzeugt. Texte werden geschwärzt, bevor sie gesendet werden.
Funktioniert die Stichwortsuche weiterhin?
Ja. Jede Suche führt Stichwort- und Vektorsuche gemeinsam aus und führt die Ergebnisse zusammen. Fällt der Vektorpfad aus, antwortet weiterhin die Stichwortsuche.
Kann Kundendokumentation bei einem anderen Kunden landen?
Nein. Dokumentation, die zu einem bestimmten Kunden gehört, wird nur zurückgegeben, wenn die KI für genau diesen Kunden arbeitet.
Quellen: Produktcode und Dokumentation von Xcellerate OPS (RMM Labs, Oktober 2026)

Bereit, die Zeiterfassungs-Compliance zu lösen?

Xcellerate OPS deckt die belgischen Zeiterfassungsvorgaben ab 2027 standardmäßig ab — ohne zusätzliches Modul.
Verwandte Artikel